你不应该只关注上下文工程
前阵子,Context Engineering 这个概念很火。
于是我就去溯源,把「12-Factor Agents」和 Dex Horthy 在 AI Enginer 上的演讲看了,「12-Factor Agents」是 Dex 结合自己为数百位 Founders、工程师提供顾问的经验,总结出的方法论:把 LLM 视作 stateless functions,把 Agent 看成普通软件中的一段循环和若干 switch 分支,并通过 12 条工程原则在可靠性、可维护性与扩展性之间取得平衡。
核心结论是:即便 LLM 的能力持续指数级增长,真正投入生产的 Agent 依旧应当是 “mostly deterministic code with LLM sprinkled in just right places”,而不是“让 LLM 盲目自循环直至完成任务”的神秘黑盒。
Dex 强调:
不管你是菜鸟还是老油条,把你对 AI agent 的大多数既有假设丢掉,退一步按第一性原理重做一遍。
他还点名 OpenAI 的 Responses ————把越多 Agents 逻辑塞到 API/后端并不是正确的出路。
起点:为什么需要“12-Factor Agents”?
Dex 一上台就抛出了一个常见痛点:市面大多数自称“AI Agent”的产品,在真正上线面对真实用户时往往止步于 70–80 %的质量线——它们要么是对第三方框架的浅封装,要么在遇到复杂场景时被迫手动写 Prompt 或穿透框架去调底层逻辑,最后结果往往是“七层调用栈里找 Prompt,找不到就重写一遍”。
Dex 把这种痛苦归因于两个误判。第一,把 Tool Use 当成某种“外星智慧操纵环境”的玄学,而忽视了工具调用本质上只是“LLM 输出一段 JSON → 交给确定性代码 → 返回结果”。第二,把“全自动多轮自反思”当成 Agent 的唯一正确姿势,却忽略了长上下文窗口、错误收敛、状态管理这些工程层面的限制。
为此,他回溯了软件工程历史:从 Heroku 时代的「12-Factor App」到今天的云原生,每一次范式转移都需要一套可复用的工程原则来约束复杂性。“12-Factor Agents”正是面向 LLM 时代的等价物——它并不是反对框架,而是给未来框架开一张“功能需求清单”,帮助团队在 可观测性、可测试性、可维护性 这三大维度上早早建立护城河。
从传统软件到 LLM Agents:核心转折与工程落点
在传统的 ETL、CI/CD 流水线里,工程师早已熟练使用 DAG 调度器(例如 Airflow、Prefect)来拆分任务依赖、控制重试次数、追踪状态。一旦把 LLM 引入这些流程,我们直觉上想做的事情只有一件:让模型“自己决定下一步”。然而 Dex 展示了一个最朴素的 Agent 循环:
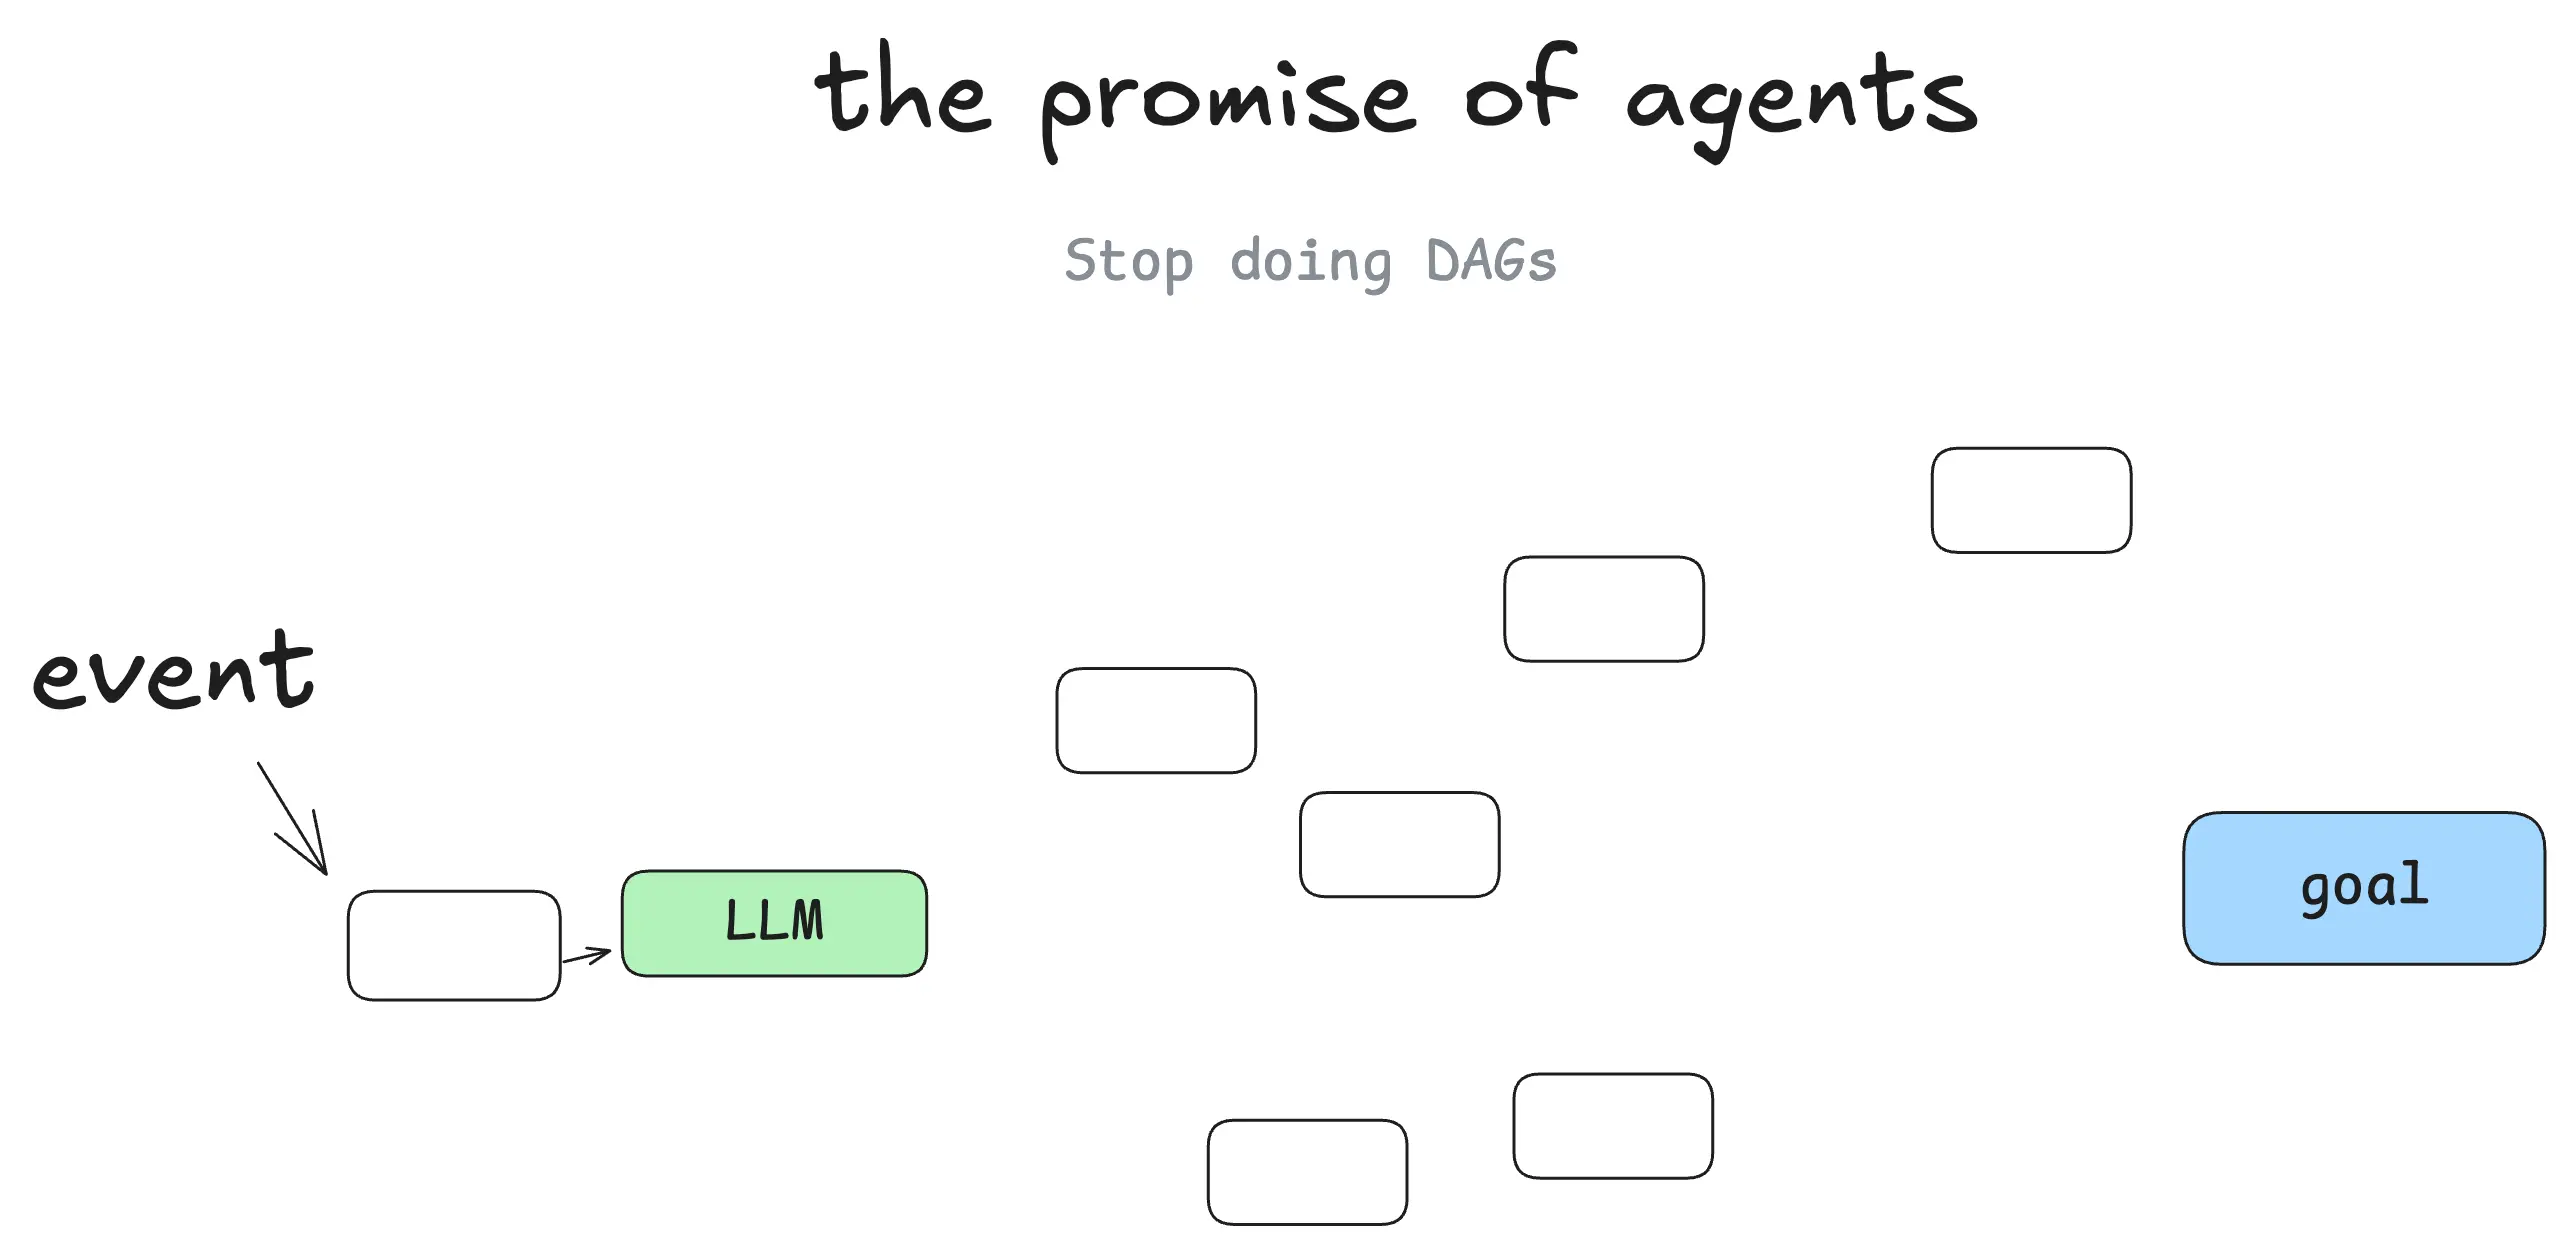
- 事件进入(用户请求 / 系统告警)。
- 拼装 Prompt(包含上下文窗口、历史记录、知识检索 RAG 结果等)。
- LLM 生成下一步 JSON(声明要调用哪个工具、需传入哪些参数)。
- 确定性代码执行(API 调用或子流程)。
- 将执行结果压回上下文。判断是否结束,否则进入下一轮。
我们的初始上下文仅仅是起始事件(可能是用户消息,可能是 cron 触发,可能是 webhook 等),我们要求 LLM 选择下一步(工具)或确定我们已经完成。
在真实实践的复杂场景中,可能是这样的一个多步骤:
物化的 DAG(已计算生成的有向无环图)看起来会像这样:
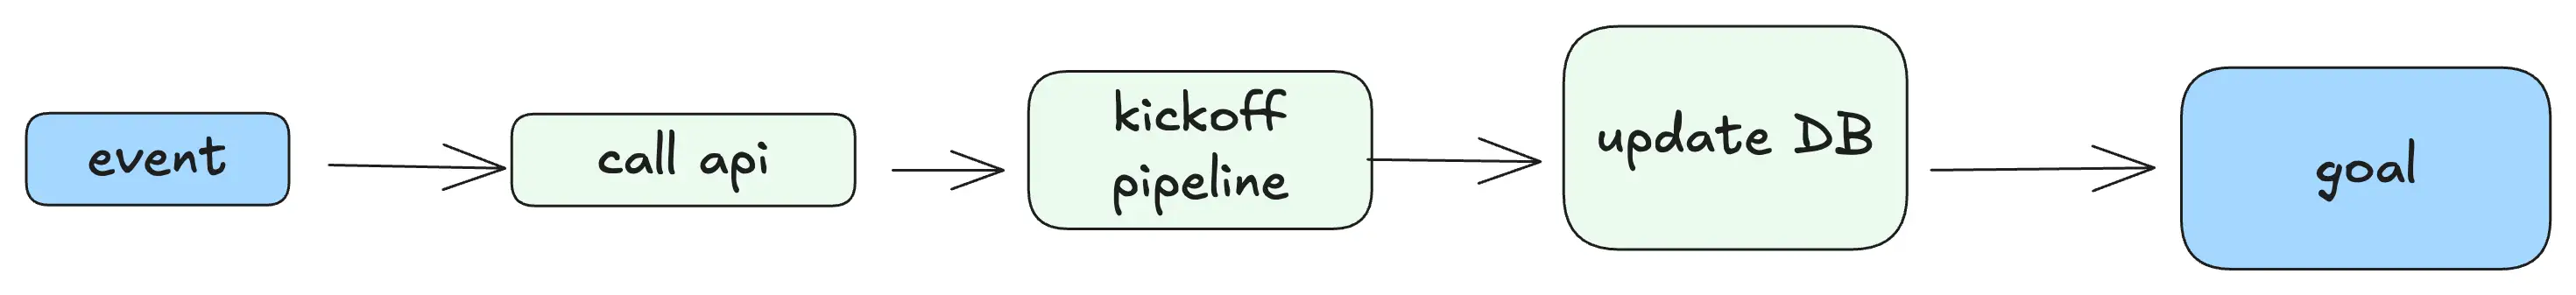
问题在于:当上下文窗口无限膨胀或错误堆叠时,这个循环很容易“旋转失控”,性能和稳定性都难以保证。Dex 因此将“Own Your Control Flow”列为核心原则之一:让人类或确定性代码,而不是 LLM 本身,主导中断、总结、回滚、重试的时机。
他进一步指出,真正落地的生产系统往往采用“Micro-Agents”的模式:业务主流程仍然是可测试、可回放的确定性 DAG,只有在“顺序不确定”或“需要语义判断”的极窄场景里,才把控制权交给 LLM 驱动的三到十步小循环。例如 HumanLayer 内部的部署机器人:在 CI 阶段完全走常规流水线,只有当需要按自然语言“先部署后端还是前端”时才短暂召唤 Agent,待部署完成又立即回到确定性代码继续执行端到端测试。
通过这种“最小必要 Agent 化”策略,团队既保留了 LLM 带来的灵活性,也避免了把所有业务逻辑写进 Prompt 的失控风险。更重要的是,每一次 LLM 能力的进化,都可以渐进替换 DAG 中的节点,而不必重写整条流水线。这为未来“2M上下文窗口 + 高可靠长链调用”时代预留了升级路径。
12 个关键因素深度拆解
下面根据 Dex Horthy 的 GitHub 文档与演讲内容,按逻辑将 12 个因素展开叙述(由于篇幅限制,这里不完全按原顺序排列,但保证每一点均被覆盖)。
LLM 最神奇之处在于把一句自然语言准确转成结构化 JSON。如果你只实现了这一步,你已经迈出了构建 Agent 的关键第一步。
Factor 1 Natural Language → Tool Calls
LLM 最神奇之处在于把一句自然语言准确转成结构化:
你能为 Terri 创建一个 750 美元的付款链接,用于赞助二月 AI 创客聚会吗?
将其转换为描述 Stripe API 调用的结构化对象,例如:
确定性代码可以获取有效 payload 并对其进行处理,最终返回类似:
我已成功为 Terri 创建了一个 750 美元的支付链接,用于赞助 2 月份的 AI 开发者聚会。这是链接:https://buy.stripe.com/test_1234567890
Factor 4 Tools Are Just Structured Outputs
Dex 甚至引用了“goto considered harmful”的类比来提醒大家:把“工具调用”神话只会带来额外心智负担。本质上工具调用不过是 JSON + Code ;别把它当魔法,把它当“switch case”就行。
Factor 8 Own Your Control Flow
如果你把“是否结束循环”交给 LLM,长链调用几乎必挂。解决方案是在外层代码显式设置 break 条件、最大步数、摘要策略,让模型只负责“下一个动作”而非“终局判断”。也就是如果你能掌控控制流,你就可以:
- Break
- Swicth
- Summarize
- Judge
这就直接引出了如何管理 Agents 的执行状态和业务状态
Factor 5 Unify Execution State and Business State
即使在 AI 领域之外,许多 Infra
系统也试图将“执行状态”与“业务状态”分离。对于 AI apps,这可能涉及复杂的抽象来跟踪当前步骤、下一步、等待状态、重试次数等。这种分离会产生复杂性,这可能是有价值的,但对于你的用例来说可能过于复杂。
更明确地说:
- 执行状态:当前步骤、下一步骤、等待状态、重试次数等。
- 业务状态:代理工作流到目前为止发生了什么(例如,OpenAI messages、tool calls 和结果列表等)。
Dex 的做法是把两者合并到同一数据库记录里,以便随时序列化 / 反序列化上下文,支持 Launch / Pause / Resume。
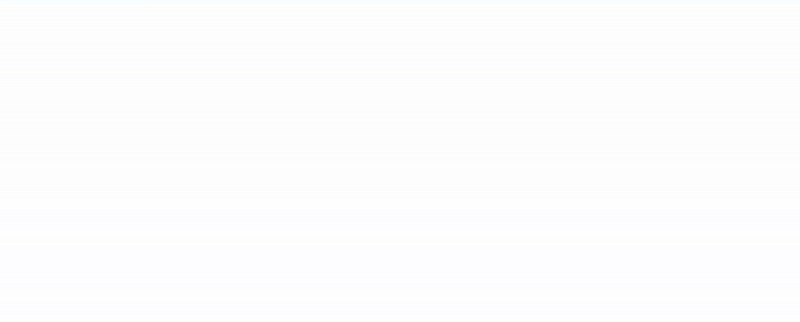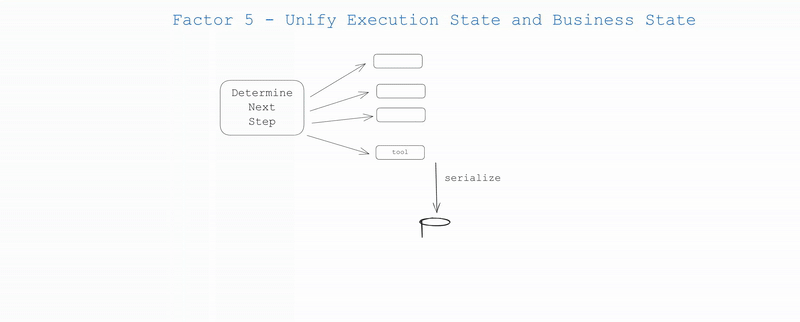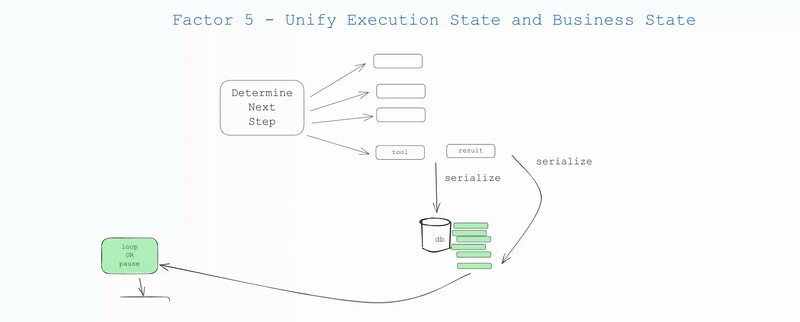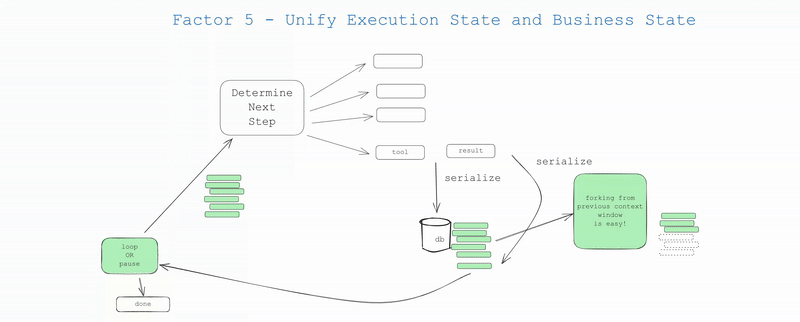
好处显而易见:
- 简单性:所有状态的一个单一事实来源
- 序列化:线程可以轻易地序列化/反序列化
- Debugging:整个历史记录可以在一个地方查看
- 灵活性:只需添加新的事件类型即可轻松添加新的状态
- 恢复:只需加载线程即可从任何点恢复
- 分支:可以在任何时间点通过复制线程的一部分到新的上下文/状态 ID 来分支线程
- 人类接口和可观察性:将线程转换为人类可读的 markdown 或丰富的 Web 应用 UI 非常简单
Factor 6 Launch/Pause/Resume with Simple APIs
既然 Agent 本质上是 loop + switch,就应该像普通微服务一样被 REST 或 gRPC 端点包裹。这样才能在长耗时任务中安全挂起,待异步回调后继续。
这里可以去思考一个问题。通常 AI 编排器会允许暂停和继续执行,但为什么在工具选择和工具执行的时刻之间不允许?
Factor 2 Own Your Prompts
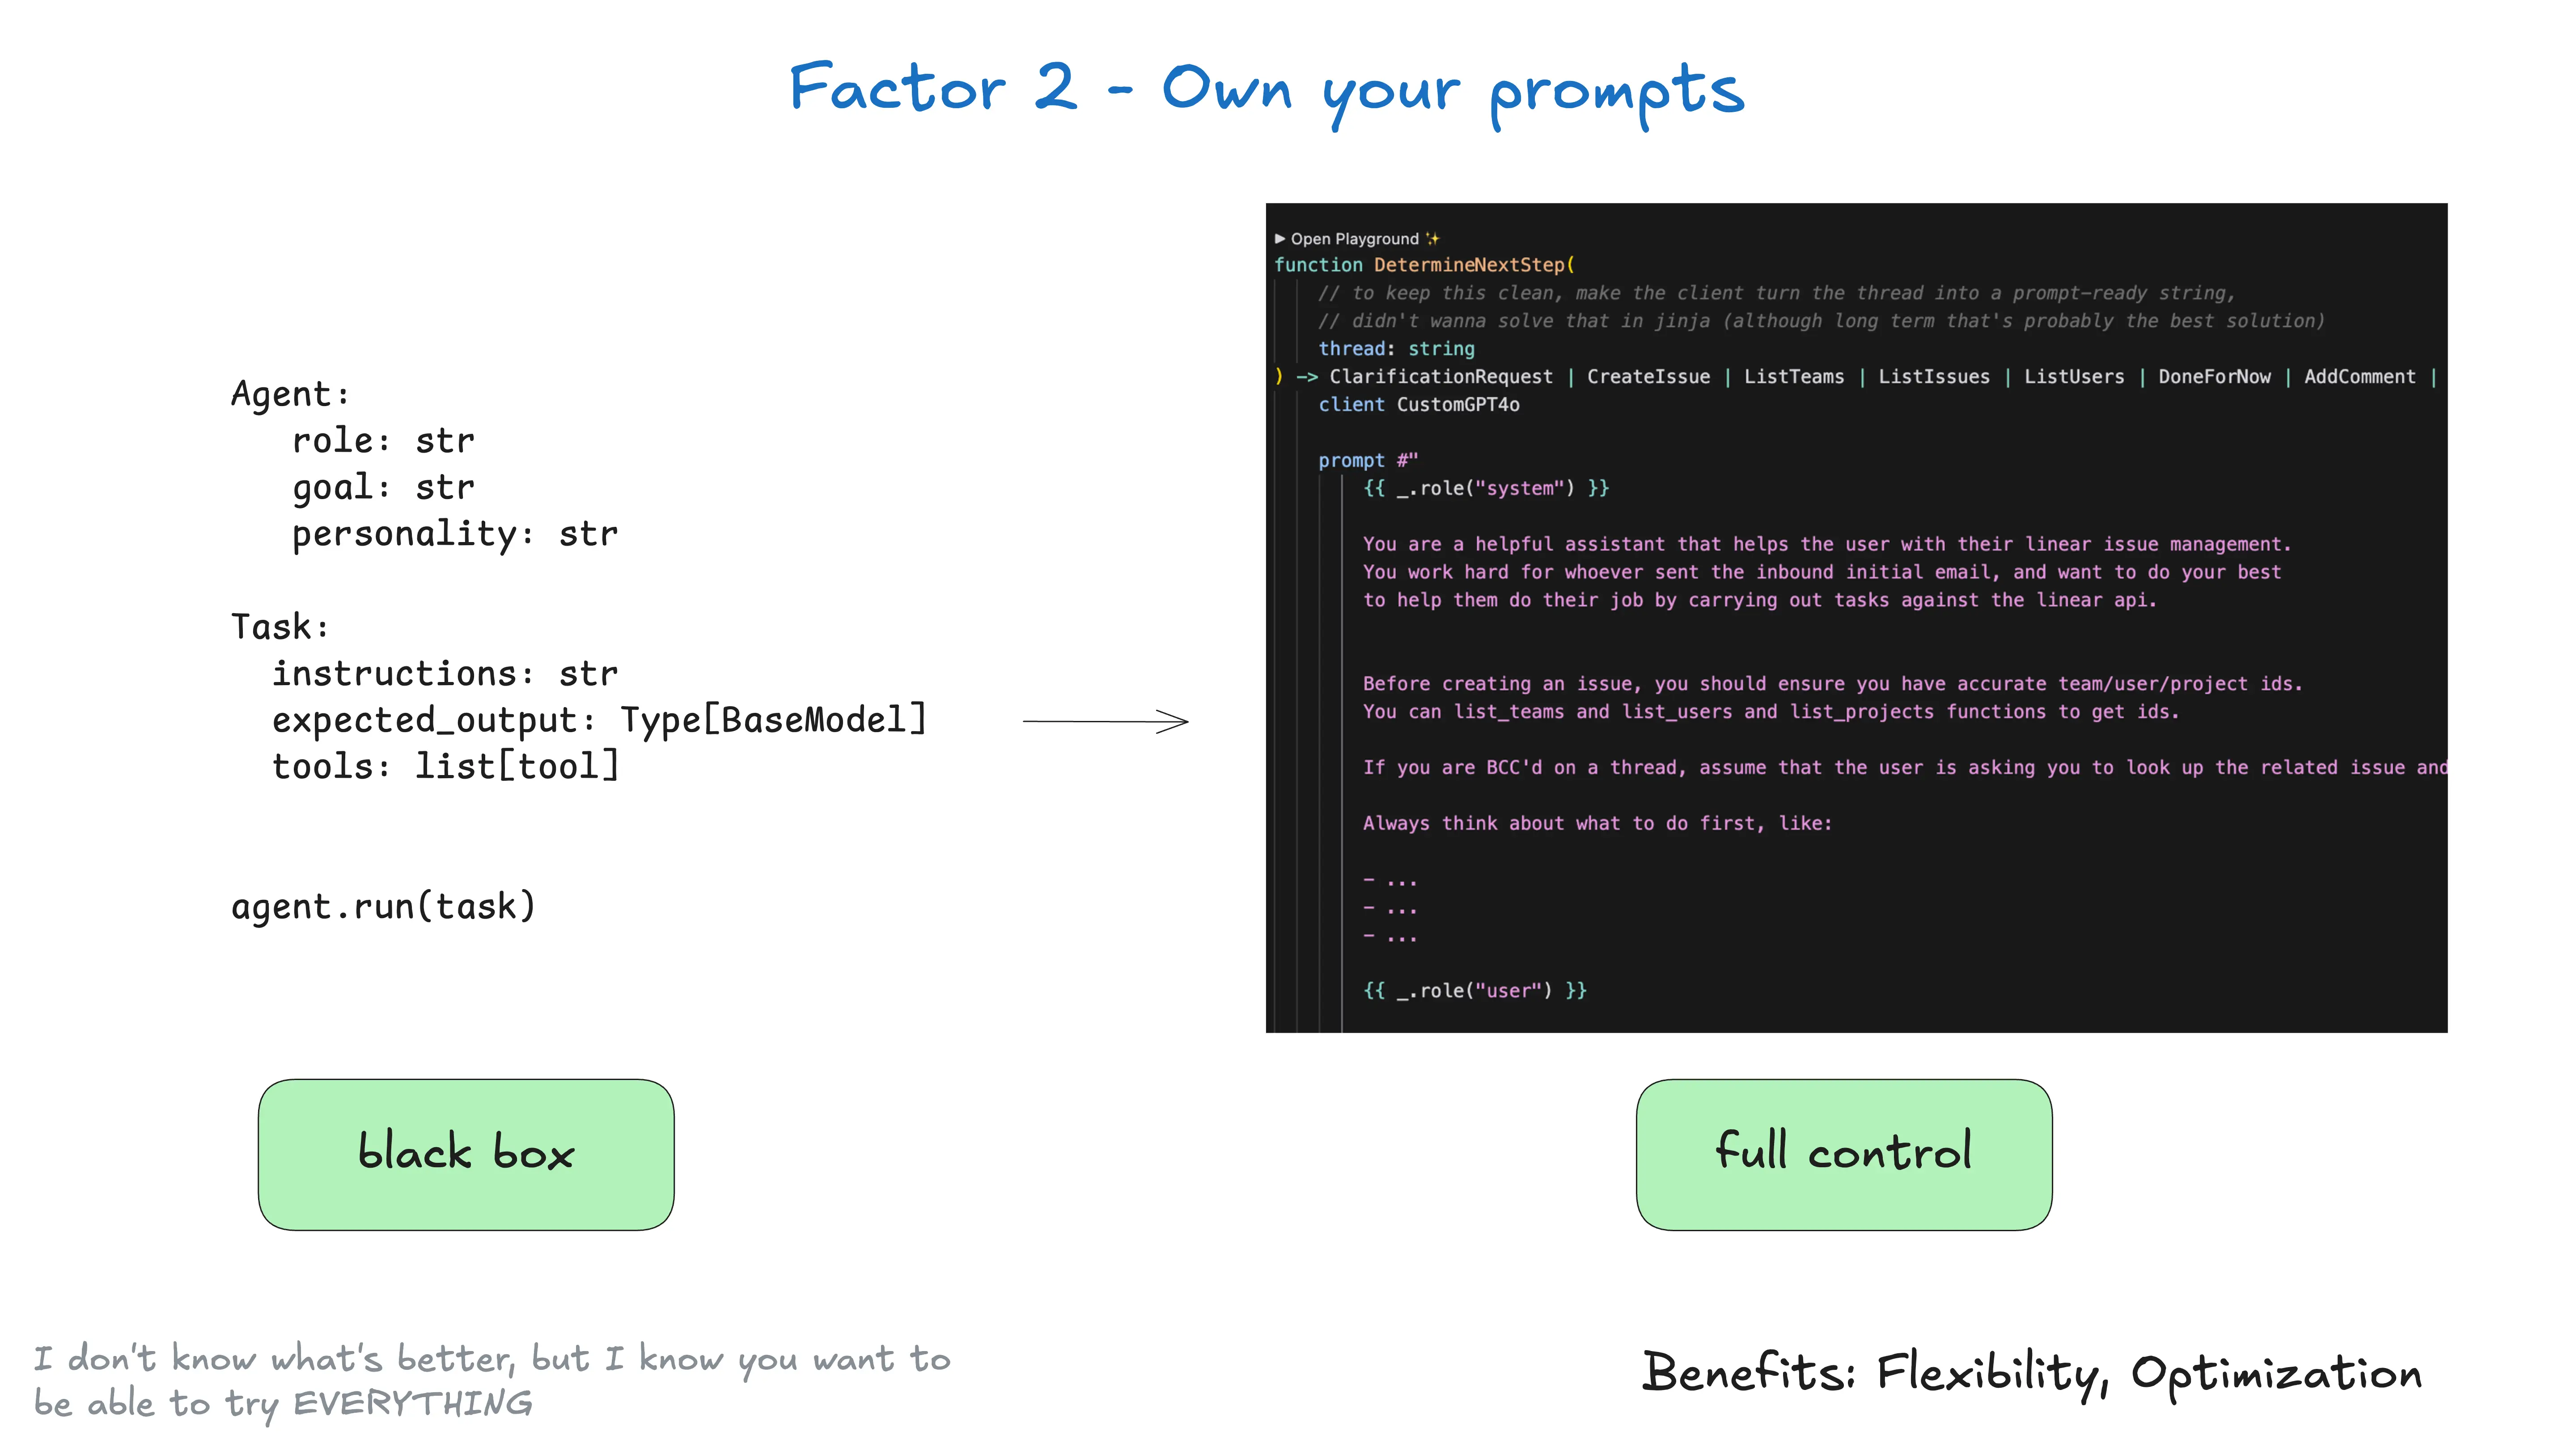
一些框架提供这种“黑盒”方法,但它通常很难调整或逆向工程,相反,要拥有自己的提示并将其视为一等代码。
Dex 强调“一定会走到手写每个 token 的地步”。原因在于:
LLMs are Pure FunctionsTokens in → Tokens out
Prompt 越长越脆弱,不同模型间迁移性差。手写能让你完全可控地 A/B test 每一段指令(可以去使用如  githubBAML 这样的 prompt engineering tool,也可以手动模版化),持续压榨模型天花板。
Factor 3 Own Your Context Window
与其把所有历史消息一条条地塞进 messages 数组,不如把“事件状态”序列化为你自定义的数据结构,再一次性放入 Prompt(也就是`content`字段)中;这样你才能精准控制 token 密度并减少“语义漂移”。
毕竟 LLM 本质上是无状态函数,将输入转换为输出。为了获得最佳输出,你需要提供最佳输入。良好的 context 意味着:
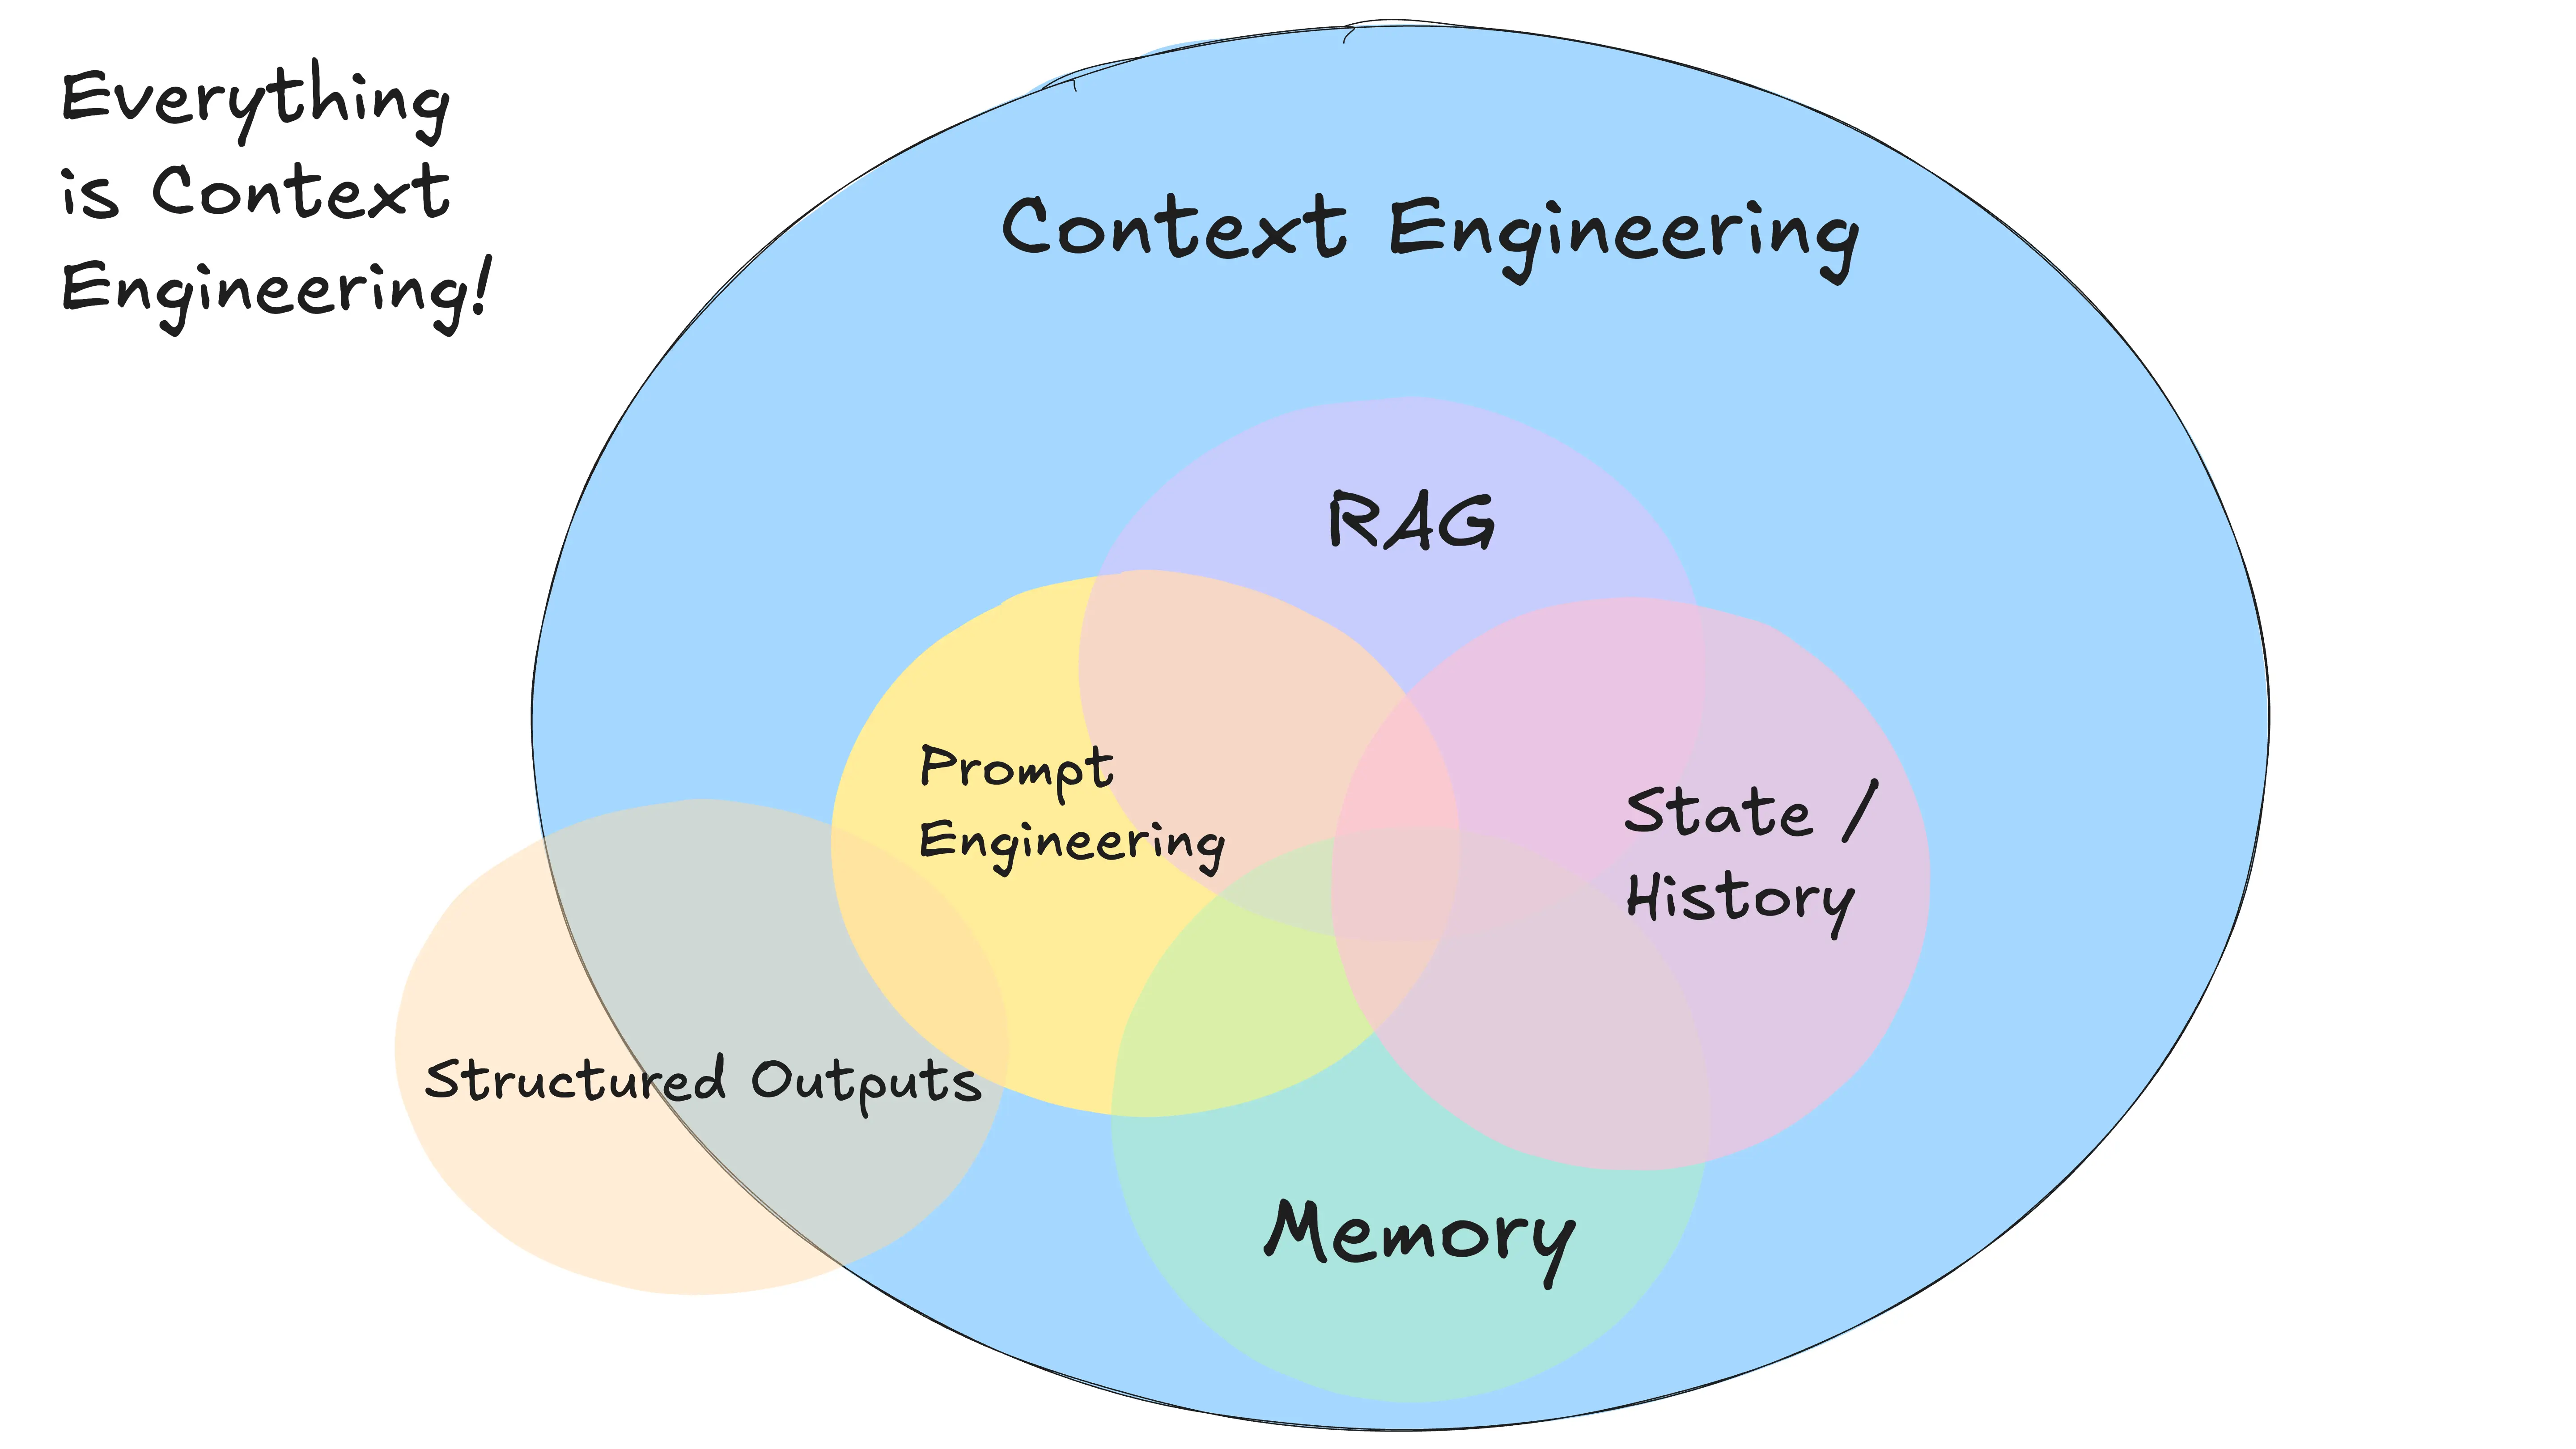
- 给模型的 Prompt 和 Instructions
- 检索到的任何文档或外部数据
- 任何过去的状态、工具调用、结果或其他历史记录
- 来自相关但独立的记录/对话(记忆)中的任何过去消息或事件
- 关于输出何种结构化数据的说明
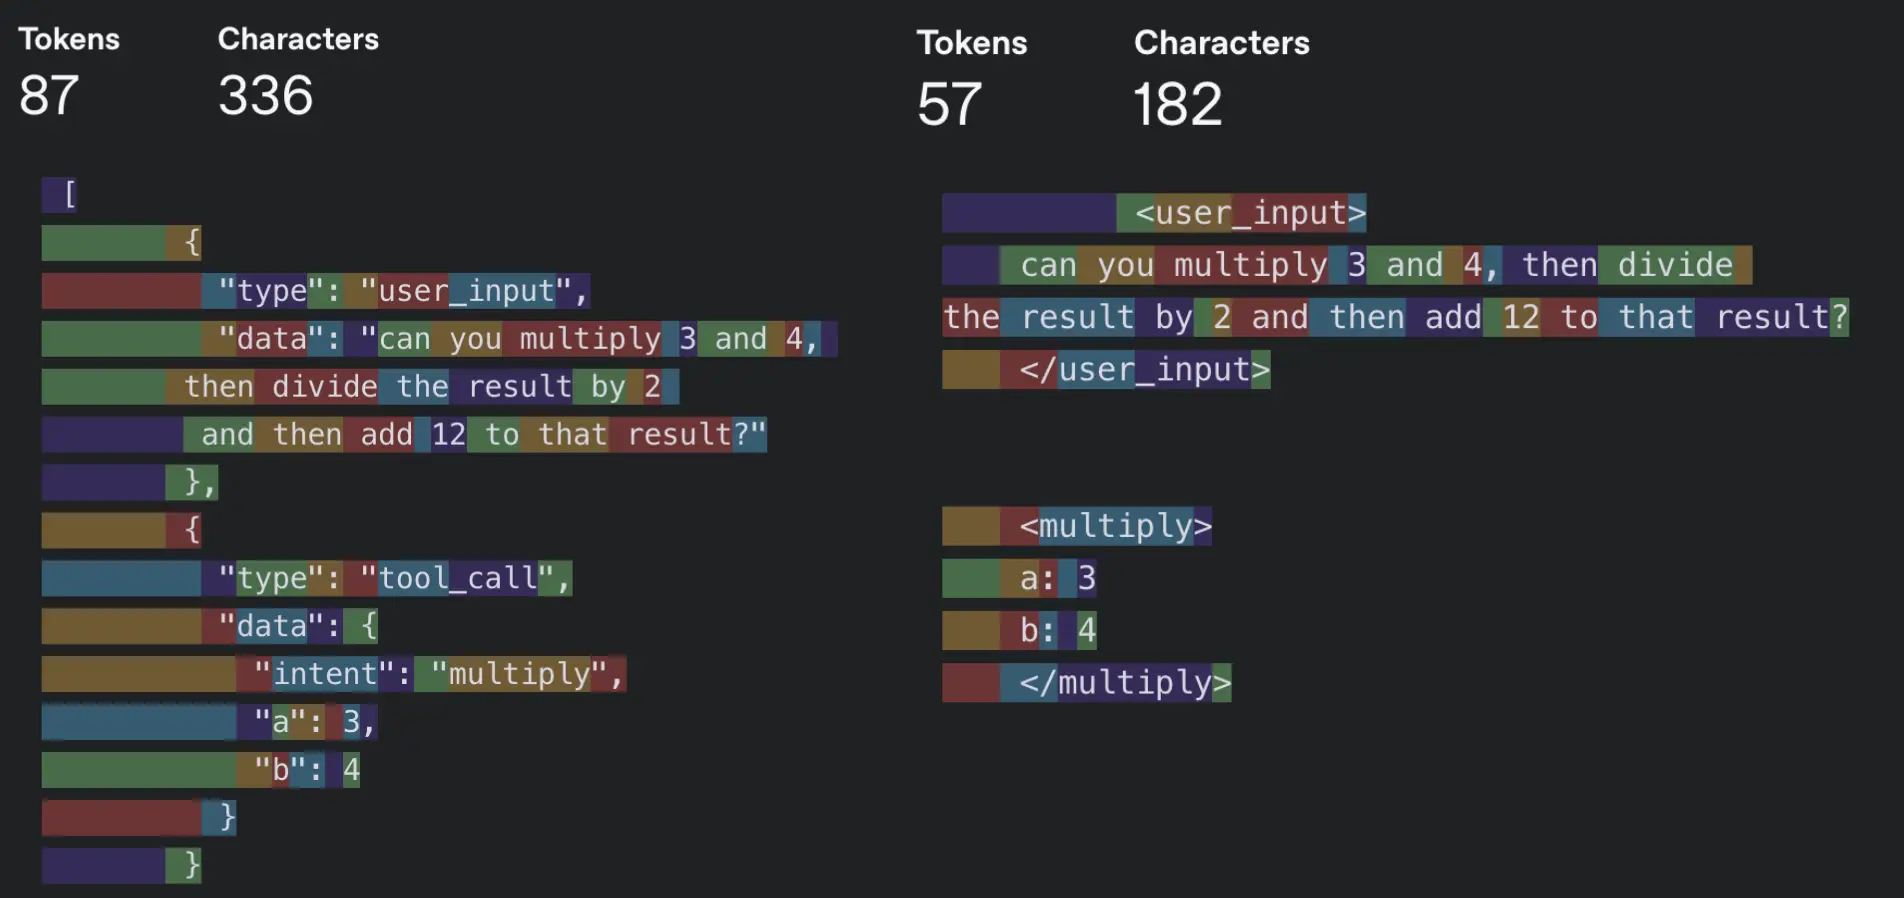
先把对话历史抽象成严格的 Event 数据结构,再用自定义的序列化函数提取关键字段并压缩为高密度表示(可用 XML/YAML/其他),最后把这一整块结果放进 `content` 发给 LLM。
信息密度到底是什么意思?—— 同一信息,更少的 token be like:
Factor 9 Compact Errors into Context Window
好的 LLM 可以读取错误消息或堆栈跟踪,并在随后的工具调用中弄清楚要更改什么。但把栈追踪原样塞回 Prompt 只会淹没关键信息。正确做法是:
- 捕获错误 → 压缩为一两句自然语言摘要 → 追加到 context
- 一旦下一步成功,立即清空历史错误,避免旧错误影响后续推理。
大多数框架都实现了 Factor 9,这里不多讲,可以留意的是:
触发连续错误阈值可能是升级到人工处理的绝佳时机,无论是通过模型决策还是通过确定性接管控制流。
Factor 7 Contact Humans with Tool Calls
Dex 观察到很多团队在设计 JSON schema 时,将“向人类发消息”与“调用机器接口”放在同一决策分支里,这会让模型难以决定优先级。
LLM 在生成第一个 token 时就要决定它接下来究竟是
- 输出给人类阅读的自然语言
- 输出给机器执行的结构化调用(JSON)
(LLM API 依赖于一个基本的 HIGH-STAKES 令牌选择)
如果这两种路径混在同一个 JSON schema 分支里,模型在采样首个 token 时就会陷入“我要说话还是要调用接口?”的高风险抉择。一旦首 token 选错,后续内容往往全盘出错。Dex 的建议是把“需要人类参与”的意图显式拆出来,让模型总是先生成一个统一格式的 JSON,并用诸如 `request_human_input`、`done_for_now` 等自然语言标记来声明其意图:
- 暂停,等待人类(澄清、批准、确认),还是
- 继续自动化(调用后续工具)
这样一来,“寻求澄清 / 需要批准 / 结束对话”这些场景都被前置成了首 token 的确定性决策,而不是与业务工具调用混为一谈。结果就是:
- 降低首 token 风险:模型不用在自然语言与工具调用之间犹豫。
- 控制流更清晰:下游框架收到 `intent:"request_human_input"` 就知道要打断循环,通知人类,然后等待回调。
- 上下文可追踪:同一 JSON 结构持续累积事件,方便日志、回放与多方协作。
具体实现如下:
定义面向人类的“工具”
这段等价于为“请人类介入”做了一个 专用工具。当 LLM 决定自己需要澄清或征得批准时,就输出符合这个 schema 的 JSON,对下游来说语义非常明确:这里必须暂停等待人类。
Agent 主循环里的分支判断
1. 判 intent → 暂停
只要看到`request_human_input`,循环立即停止,把当前 thread 状态保存,并把问题发到 Slack、邮件或别的渠道。
2. 保存状态 → 可恢复
`save_state`将执行栈、上下文窗口等都序列化,形成`thread_id`,保证代理可以“掉电续跑”。
3. 通知人类 → 等待回调
真正的人机交互发生在外部:用户在 Slack 点了 “Yes”,第三方系统会把结果 POST 回`/webhook`。
Webhook 收到回复后的恢复逻辑
Webhook 把人类回复追加为事件,然后重新调用`determine_next_step`,等同于把对话“接回”代理循环,之后可以继续自动化(例如`deploy_backend`)。这一整套流程正是“前置人类意图”在代码中的落地:
- 首 token 已经确定分支,不存在“误选自然语言 vs JSON”带来的随机偏差;
- 状态持久化 + 事件日志 让整个工作流可回放、可审计;
- 外部触发(cron、webhook、事件流)得以轻松接入,实现“Outer-Loop Agents”。
顺着往下想,Dex 提到过更宏观的第三代 Agent 形态—— theouterloopOuter-Loop Agents:它们由软件或人类一次性触发,却可能连续运行 分钟、小时乃至数天,期间会自主“召唤”人类来获取批准、补充信息、重定向策略。核心挑战就是长生命周期里的 “Agent→Human 接口”——必须让代理随时可靠地联系到正确的人,并在人类响应后继续执行。
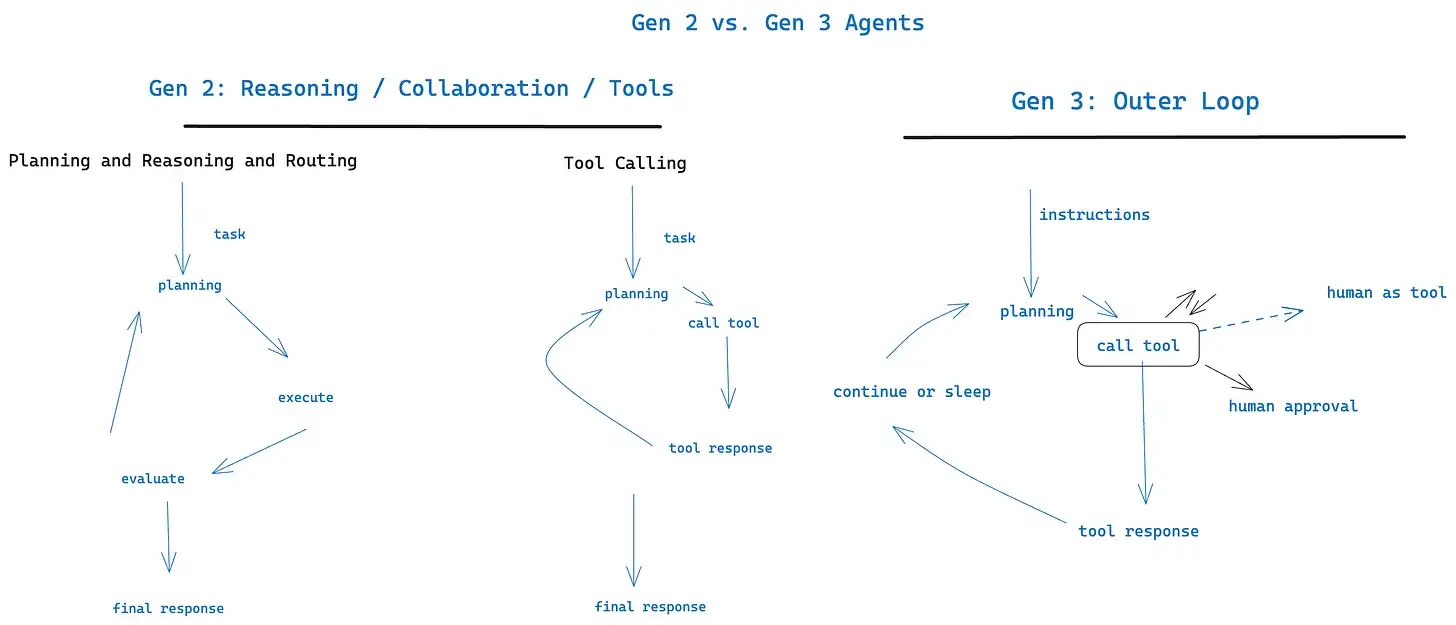
Factor 7 与 Factor 11 配合使用效果更佳,如果你能够快速地让各种人类参与进来,你可以给 Agent 访问高风险操作的机会,例如发送外部邮件、更新生产数据等。
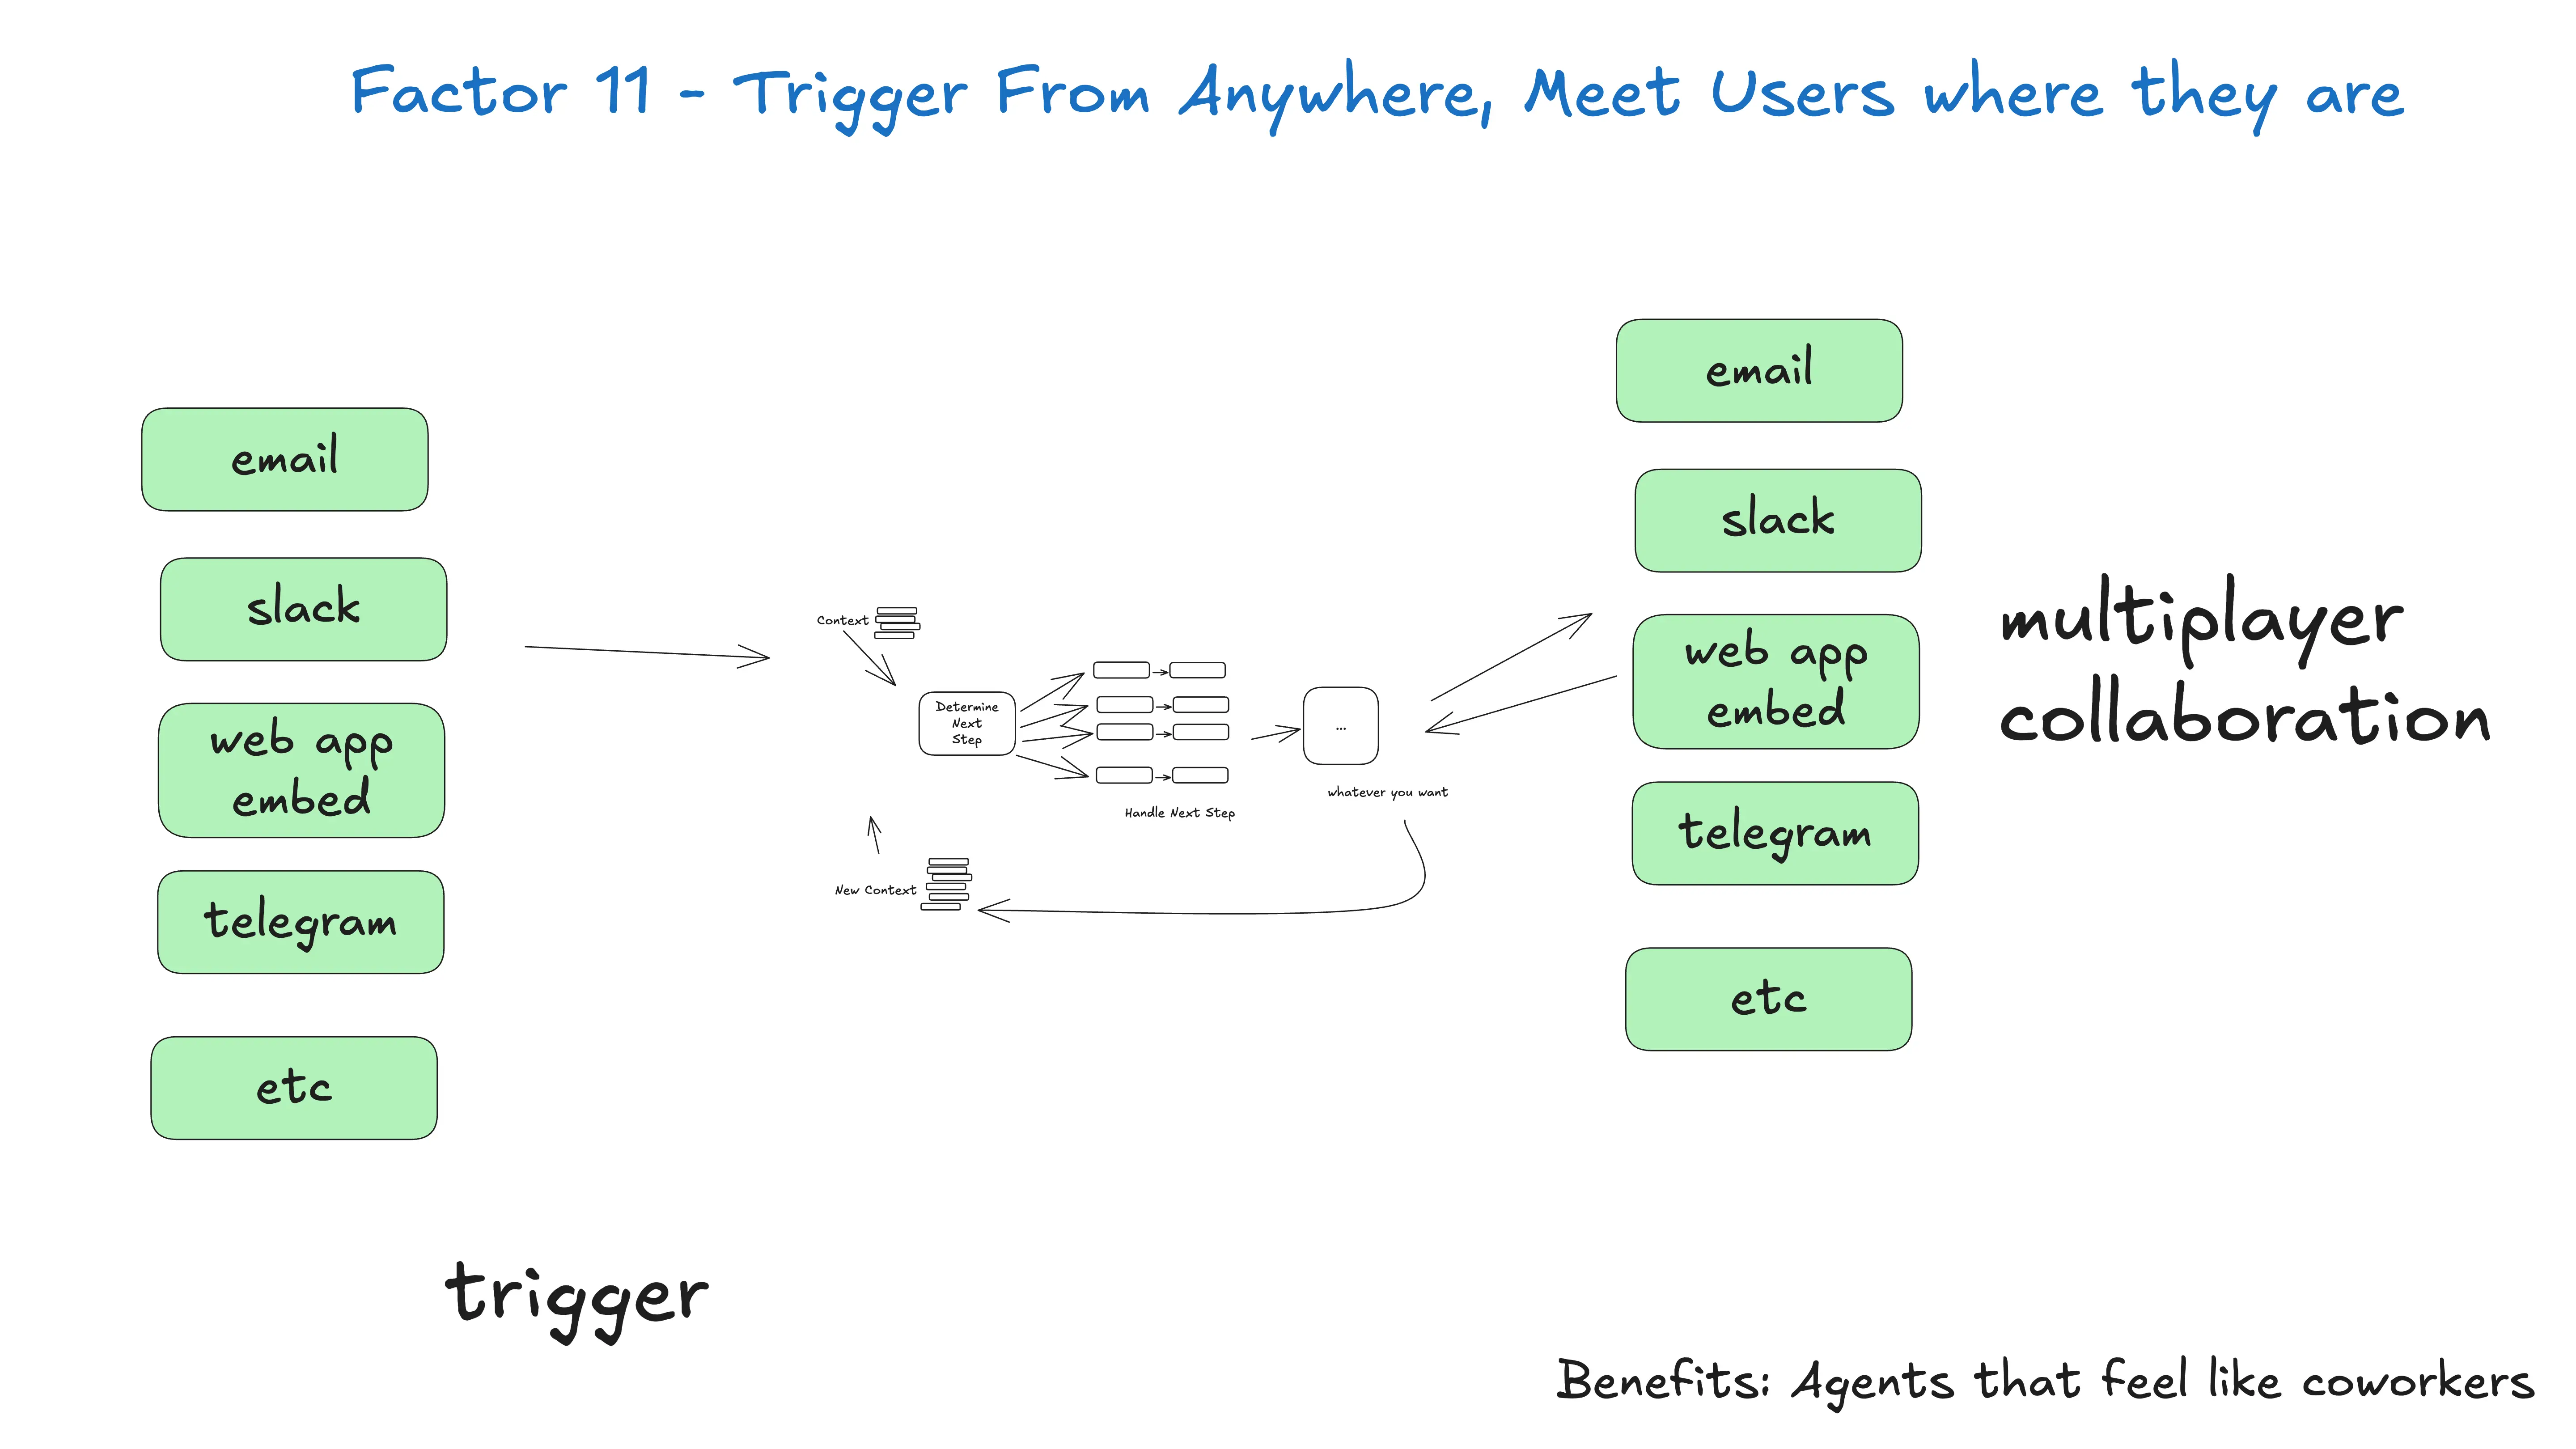
Factor 11 Trigger from Anywhere, Meet Users Where They Are
真正的 Agent 不应局限于“又一个聊天窗口”。电子邮件、Slack、Discord、HTTP Webhook……只要用户已经在的渠道,都应该成为触发入口。
Factor 10 Small , Focused Agents
与“万能大循环”相对,这条原则主张用**极窄责任范围**的 micro-agent 替换一长串动作,让每个子 Agent 只处理 3–10 步。
因为任务越大、越复杂,所需的步骤就越多,这意味着更长的上下文窗口。随着上下文的增长,LLM 更有可能迷失方向或失去焦点。
小而精的 agent 的做法既减少了上下文窗口,也 方便插入人工检查点。
Factor 12 Make Your Agent a Stateless Reducer
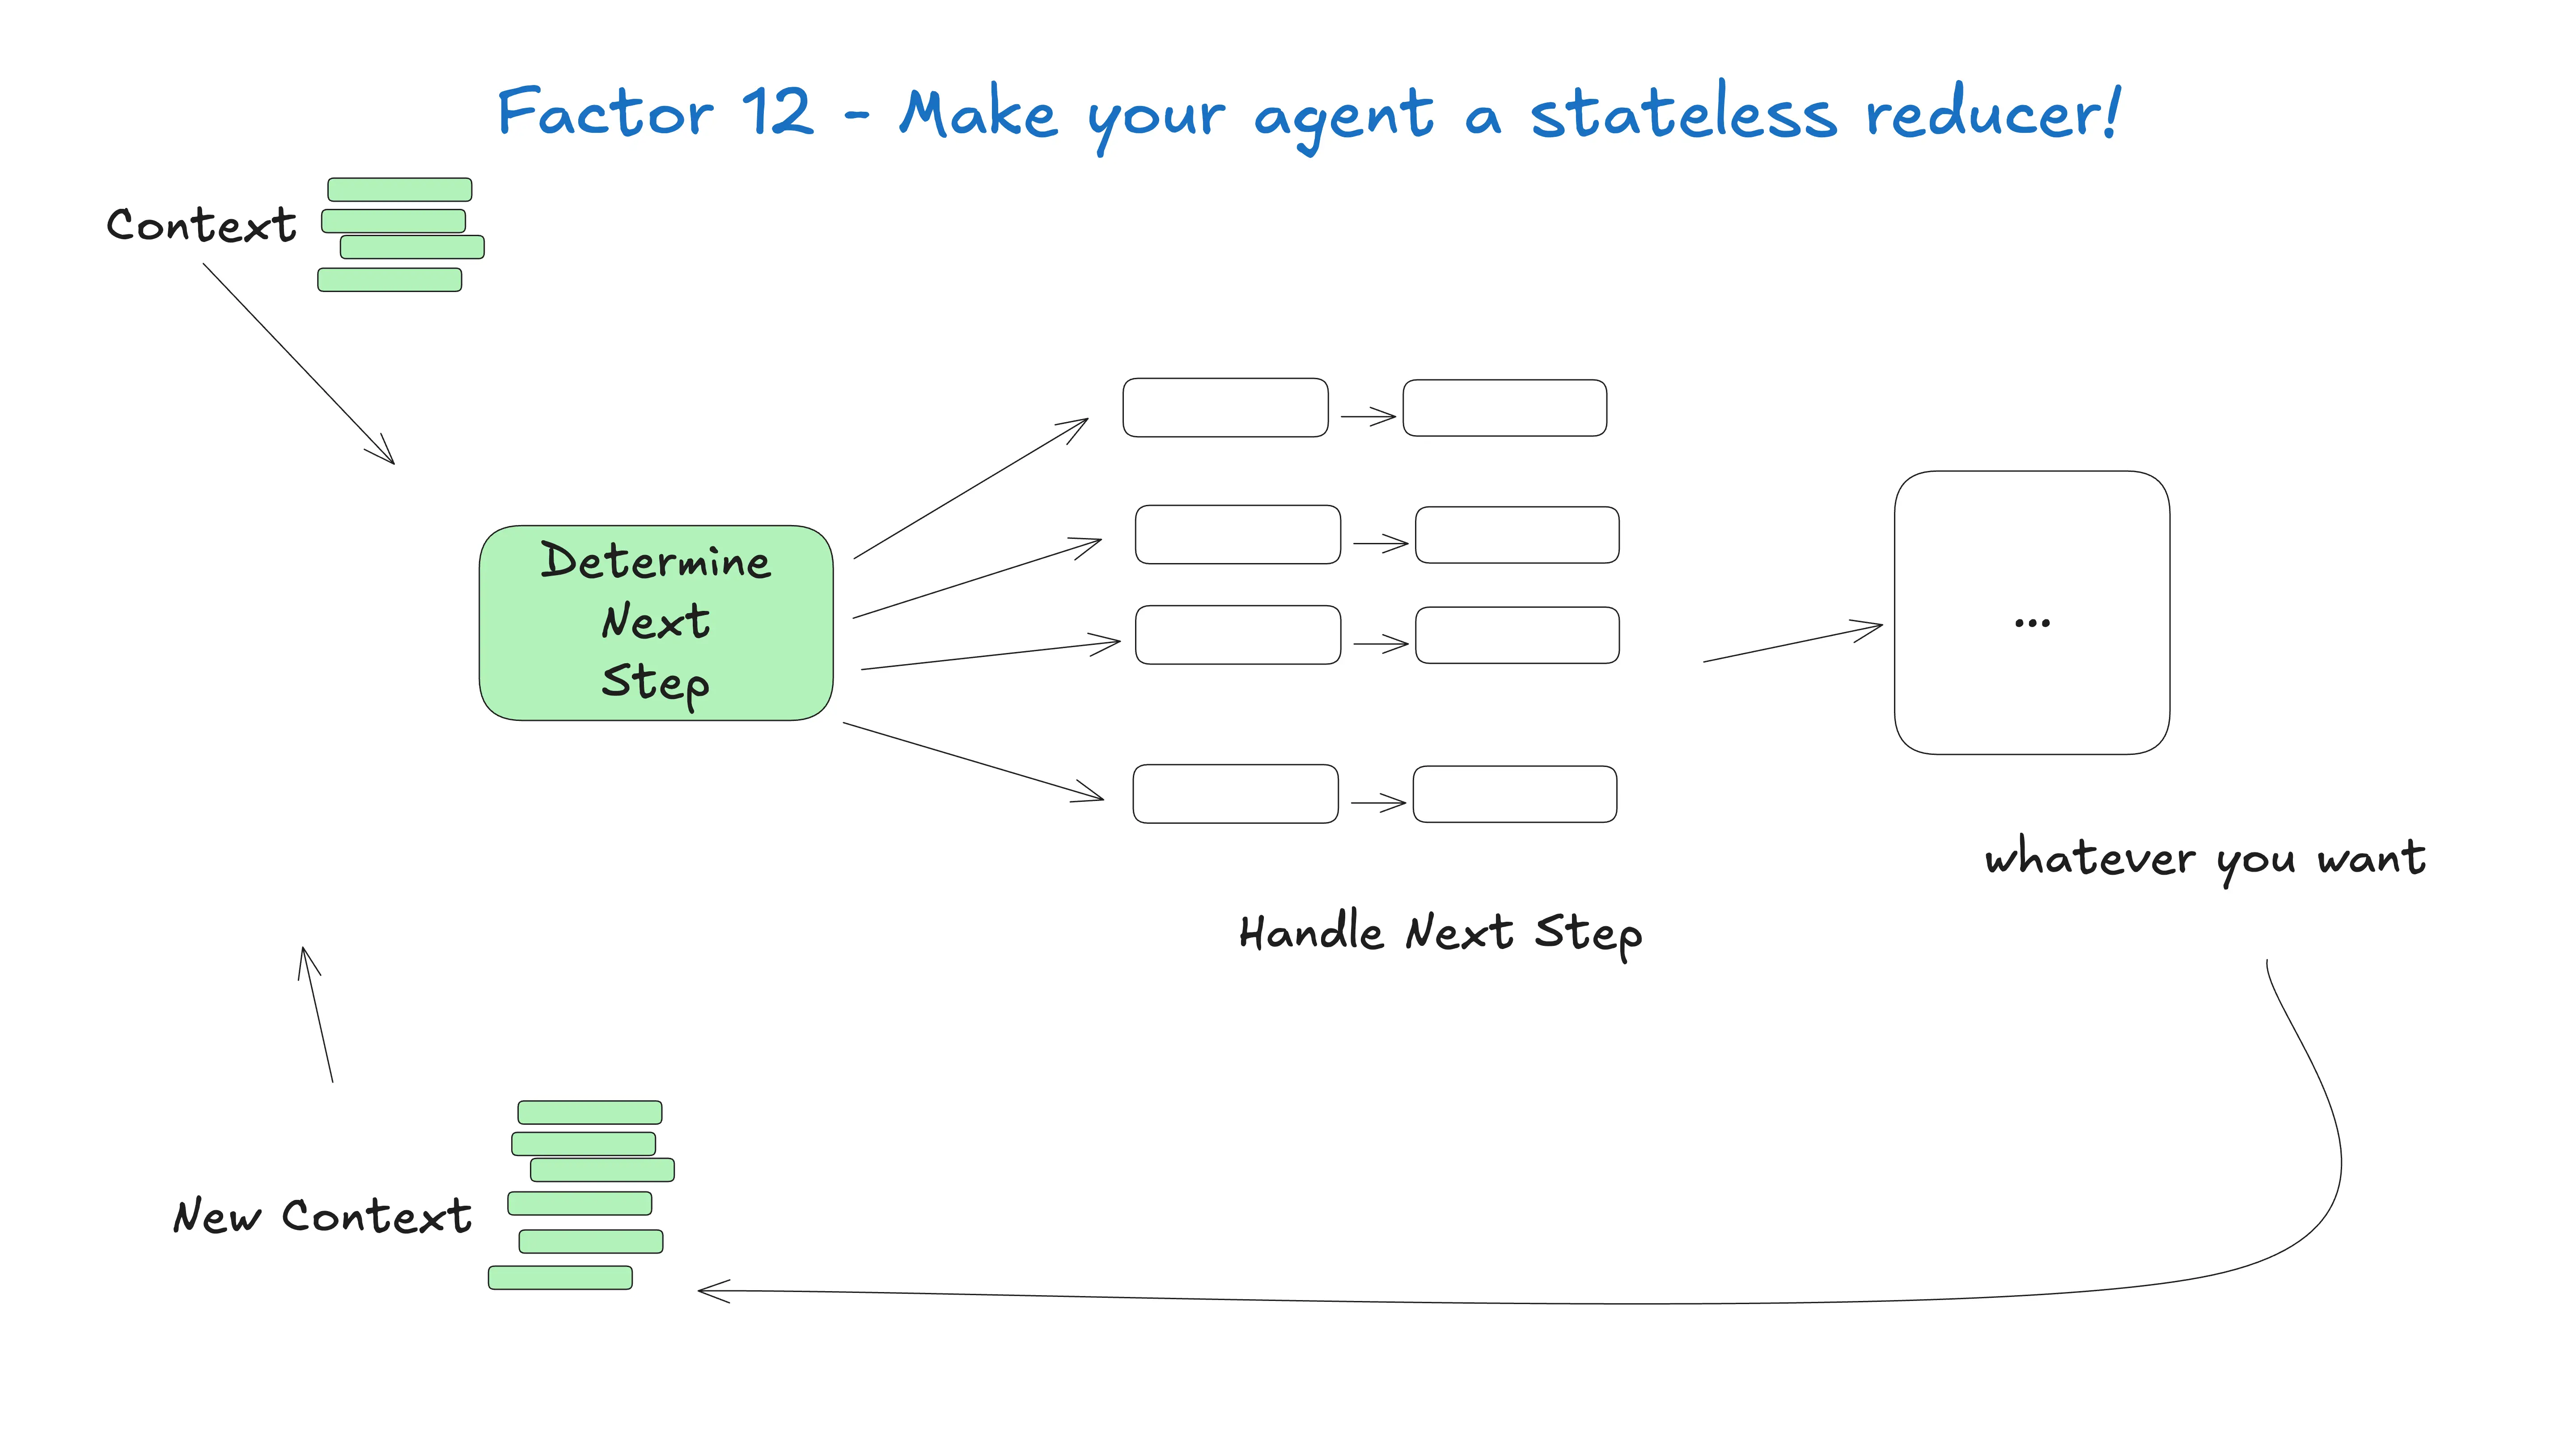
Dex 借用函数式编程的 Reducer 概念:Agent 应当不持久化任何内部状态,而是把需要记住的东西交给外部存储。
为什么叫 “Stateless Reducer”?
1. Reducer 概念源于函数式编程里的 `fold`/`reduce`:
- 输入:累积值 (accumulator) + 当前元素
- 输出:新的累积
2. 我们可以把 context window 当成累积值,把 LLM DetermineNextStep + switch dispatcher 当成 reducer 函数。每轮循环:
3. “Stateless” 意味着这段 reducer 本身不持久化任何内部数据;它只是纯粹计算`new_context`,然后马上交还给外部存储(数据库、缓存、对象存储等)保存。
Agent 只是一个“语义层的 Map-Reduce”,而你的业务可靠性来源于外部持久化与纯函数式迭代。一旦抓住“状态外置 + 纯 Reducer”这条主线,其余优化(RAG、长链、多人协作)都能在同一框架下渐进融入。
这样你才能随时水平扩容、A/B 切流,或在高可用集群里自由迁移。
总结
1. “Agent = Loop + Switch” 思维模型
抛开营销包装,绝大多数生产级 Agent 都可以被拆解成四个同步执行的部件:
- Prompt / Context Builder:决定给 LLM 看的 token;
- LLM Call:纯函数,输入 token 序列,输出 token 序列;
- Switch Dispatcher:把 LLM 输出映射到确定性工具;
- Loop Controller:决定何时 break、何时 summarize、何时 pause。
当你把 Agent 还原成这个最小闭环,团队就能像优化普通后端服务一样对其进行单元测试、负载监控、自动回归,而不再被“黑盒大模型不可控”所束缚。更重要的是,这种分层让你可以独立演进任意一环:换模型、换向量检索、换数据库,都不会牵一发动全身。
2. “最小必要 Agent 化” 渐进式演进框架
Dex 用 HumanLayer 内部部署机器人的案例证明,一条成熟的业务流水线应当:
- 第一阶段:保持 100 % 确定性代码,先把“可回放、可监控、可断点”打牢。
- 第二阶段:识别“高语义判断”瓶颈(例如部署优先级决策),用 3–10 步的 micro-agent 替换。
- 第三阶段:当 LLM 能力升级、上下文窗口扩容时,把更多节点渐进式迁移到 Agent,但每一步都要**走可观测、可回滚**的流程,而非一次性重写。
此框架背后的心智模型是:LLM 不是魔法,而是一款逐年升级的加速卡。你无需押注它一次性解决所有问题;相反,保持代码架构的“可替换性”才是长期竞争力。
3. “Prompt 与 Token 密度” 的工程思维
提示词工程不是艺术创作,而是一场信息压缩与信噪比预算的游戏:
- 压缩:每多放一个无关 token,都是对上下文窗口与推理梯度的浪费;
- 信号:保留的每个关键词都应对输出有可测量的正向影响;
- 预算:窗口越小、成本越低、可复用性越高。
因此,团队需要像优化 SQL 查询那样持续 Profile & Refine Prompt:记录每次修改对评测指标的影响;对 Prompt 片段做单元测试;把 RAG、Memory、System Message 看成独立模块,分别调优。最后,你会把 Prompt 打造成一种“可编排资源”,而不再是拷贝粘贴的长文本。
Reference
[1] https://github.com/humanlayer/12-factor-agents
[2] https://www.youtube.com/watch?v=8kMaTybvDUw
[3] https://theouterloop.substack.com/p/openais-realtime-api-is-a-step-towards


