为什么我觉得解决记忆问题的产品不会是 mcp 形态的?
把记忆从「显式剪贴板」升级到「隐式认知模型」,中间隔着一条深不见底的沟壑。
背景:一次“不够聪明”的 Demo
上个月,我用 mem0 和 Zep 的 SDK,做了些小 Demo 和 mcp server
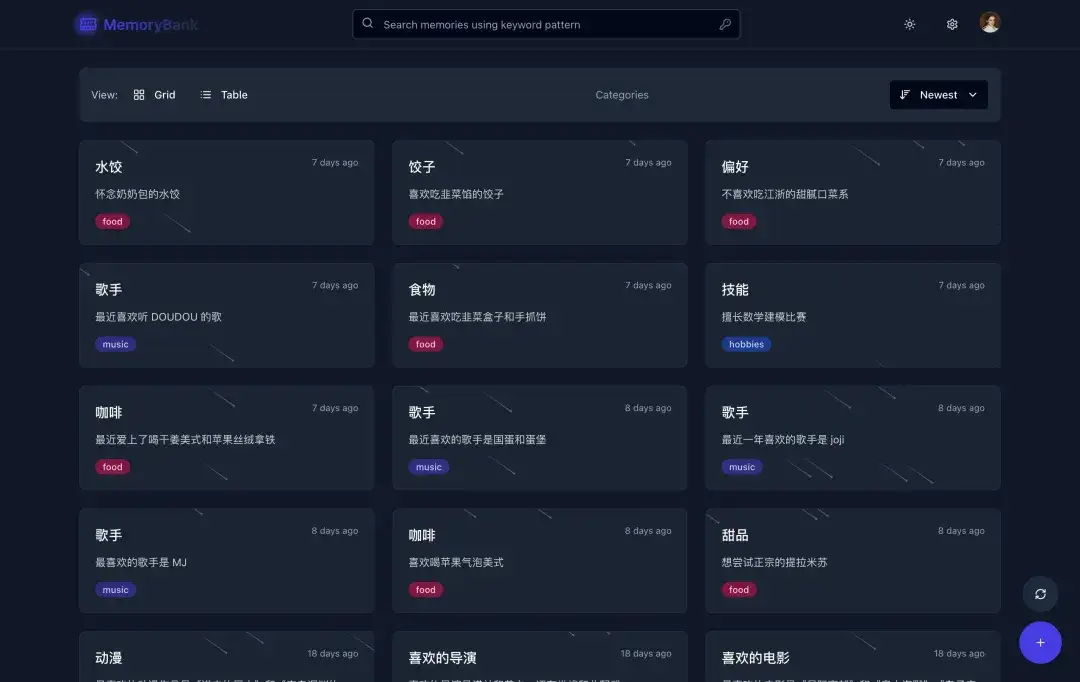
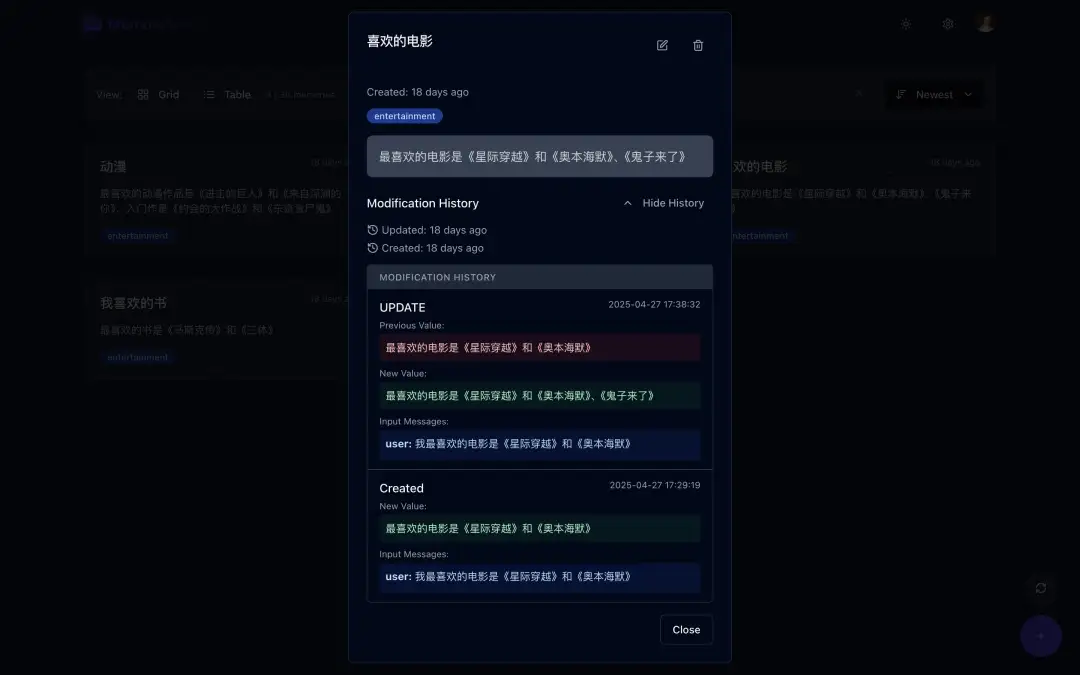
我满怀期待,希望在记忆的加持下,LLM 能更懂我。然而,现实却给我泼了一盆冷水:
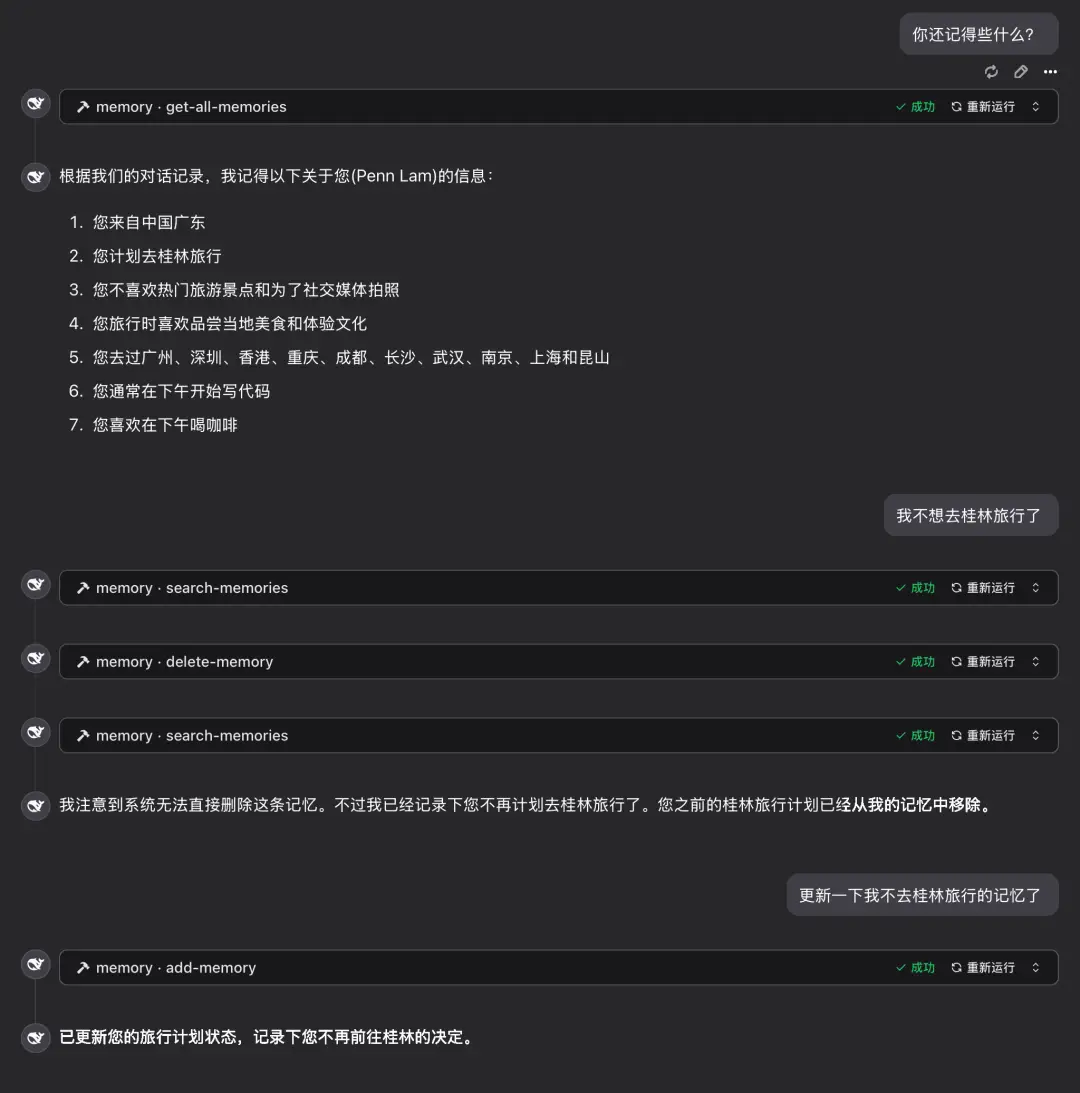
这些系统最多只能抓到“记性我…”这类显式指令或一两条偏好,根本谈不上 ChatGPT 那种全局、抽象、甚至可推理的隐式画像。
我发现,无论是我的小 demo,还是像 Windsurf、Augment 甚至新版 Cursor 这些成熟产品,它们的“记忆”功能都显得异常笨拙。它们能记住我明确下达的指令,比如“记住我的 GitHub 简介是 xxx”,但却无法从我与它的日常对话中,洞察到我“喜欢喝咖啡”这个简单而隐晦的偏好。
这种体验上的断裂感让我不禁思考:为什么在“自动记忆”这个场景里,当前主流的 MCP 架构会显得如此“先天别扭”?这仅仅是产品没做好,还是背后有更深层次的结构性原因?
经过一番探究,我发现,答案藏在协议的设计哲学里。
为什么 MCP 在“记忆”场景里显得先天别扭?
其实,无论是 mem0 还是 Zep,在“写、查、删”这道 CRUD 题上都答得不错。然而它们有一个共同特点:写入的粒度 = 每次工具调用传来的片段。这就意味着,记忆天然是「显式、具体、短窗口」的。
换句话说,只要用户没有明确提出“请你记住”,工具也不会主动提取记忆;即便记住了,也仅是某次对话中显式标出的语句,缺乏更长期、更深层的语义抽象。
隐式偏好为何提炼不出来?——四个结构性掣肘
为什么“我更容易对具象类比响应积极,对抽象推理回应冷淡”这种行为模式无法被自动归纳?我们可以从 MCP 的四个结构性设计限制出发,看清它在建构深层记忆时的掣肘:
- 数据入口狭窄:
- 具体表现:只有那些被 Host 或 IDE 主动通过 add_memory() 函数添加的文本,才能进入记忆库。
- 根本原因:这主要是因为 MCP(最小权限原则)的默认设置,导致服务器无法访问完整的上下文信息。
- 时间跨度短:
- 具体表现:Graphiti 会根据每次会话生成图谱,而 mem0 默认情况下只保留向量数据 1 到 2 周。
- 根本原因:缺乏一个异步归档或摘要层机制来长期保存和管理信息。
- 语义层级浅:
- 具体表现:mem0 存储的是纯文本向量,Graphiti 存储的则是实体关系图,但这些数据并没有进一步的语义提炼。
- 根本原因:系统中没有官方的“洞察”字段或一套语义提炼流程。
- 缺乏模式探测:
- 具体表现:系统没有聚类、统计或规则挖掘的能力,因此无法从多次相似的对话中归纳出用户的行为偏好。
- 根本原因:这需要额外的 Cron Job 和 LLM(大型语言模型)支持,但目前在这方面的生态示例非常稀缺。
这些掣肘导致了一个共性问题:偏好提炼不是不可能,而是“没人做”,因为默认责任不在协议内。
显式触发是协议级设计,不是客户端偷懒
如果说“隐式记忆缺位”是表象,那么“只能显式调用 add_memory() ”才是协议设计层面的根因。
在 MCP 中,记忆是一种明确的 Tool 调用 ,只有当模型主动发起调用时,Server 才会将内容写入数据库。
例如,在 Cursor 的用例中,必须用户先说出「我希望它记住我的 GitHub 简介信息」这样明确的请求,客户端才会触发add_memory()。
这种显式触发机制并非设计疏漏,而是出于权限与安全模型的考虑:
- MCP 架构分为 Host / Client / Server 三层隔离,Server 默认拿不到完整对话,只能接收 Host 丢给它的字段,从而保障工具间数据隔离。
- 所有记忆写入操作都需用户显式触发同意,避免隐私争议。
但代价是,任何“非显式”的信息点(如情绪、偏好、行为模式)都不会被自动捕获,用户要么得频繁手动记忆,要么就彻底错过。
Server 视野受限,难以做深层洞察
再进一步,我们会发现:MCP 协议不仅不支持隐式触发,甚至Server 本身就被限制无法“洞察全局”。
MCP 的设计原则之一明确规定:“Server 不应该也不能读取完整上下文”。因此:
- Server 最多只能拿到 Host 显式传来的几条消息(例如当前 turn 或截断后的上下文)。
- 不具备 ChatGPT 那种“先全文 ➜ 后摘要 ➜ 再聚类”的多级信息处理流水线。
- 想做长期行为模式识别,只能依赖外围的 Cron Job / Webhook 等异步处理手段,已经脱离了 MCP 协议的职责范围。
这种结构几乎注定了:Server 只能做低频、低粒度的洞察,无法支撑“自动感知 + 抽象总结”的记忆系统。
结果就是:碎片、临时、具体
综合上面的分析,MCP 下的记忆系统呈现出三个核心特点:
- 碎片化:
- 问题表现:系统只保存那些被明确提及的句子,导致信息是零散的。
- 产生原因:这是因为缺少自动的候选过滤机制,也没有对信息进行置信度打分的流程。
- 临时化:
- 问题表现:用户的偏好很难随着时间的推移而减弱,也就是说,旧的偏好会一直存在,影响新的判断。
- 产生原因:系统中没有时间衰减机制,也没有权重递减字段来处理信息的时效性。
- 缺乏抽象能力:
- 问题表现:系统仅仅存储原始文本,无法从中提炼出更高层次的意义。
- 产生原因:这是因为没有官方定义的“洞察 schema”,也没有一个聚类的处理流程来对信息进行归纳和抽象。
这些问题并非技术难题,而是生态默认没人做;协议提供了螺丝钉,却没附带装配图或电动螺丝刀。
结论:MCP 不是“开箱即用”的记忆服务
MCP 并不是一个“Memory-as-a-Service”系统,而只是一个「记忆的协议层组件库」——它暴露了“写入 / 查询 / 检索”等原始 API,但并不自动完成任何记忆工程。
如果你希望 AI 无感捕捉出「我更容易对具象类比响应积极,对抽象推理回应冷淡」这样的长期偏好,仍需在 MCP 之上额外叠加:
- 事件检测
- 异步摘要
- 行为聚类
- 置信度建模
……也就是说,你得自己造一整条记忆提取链路。
ChatGPT 的记忆系统是如何运作的?
ChatGPT 的记忆系统运作方式可以总结为下,详情可以看 Eric Hayes 写的 macro逆向分析
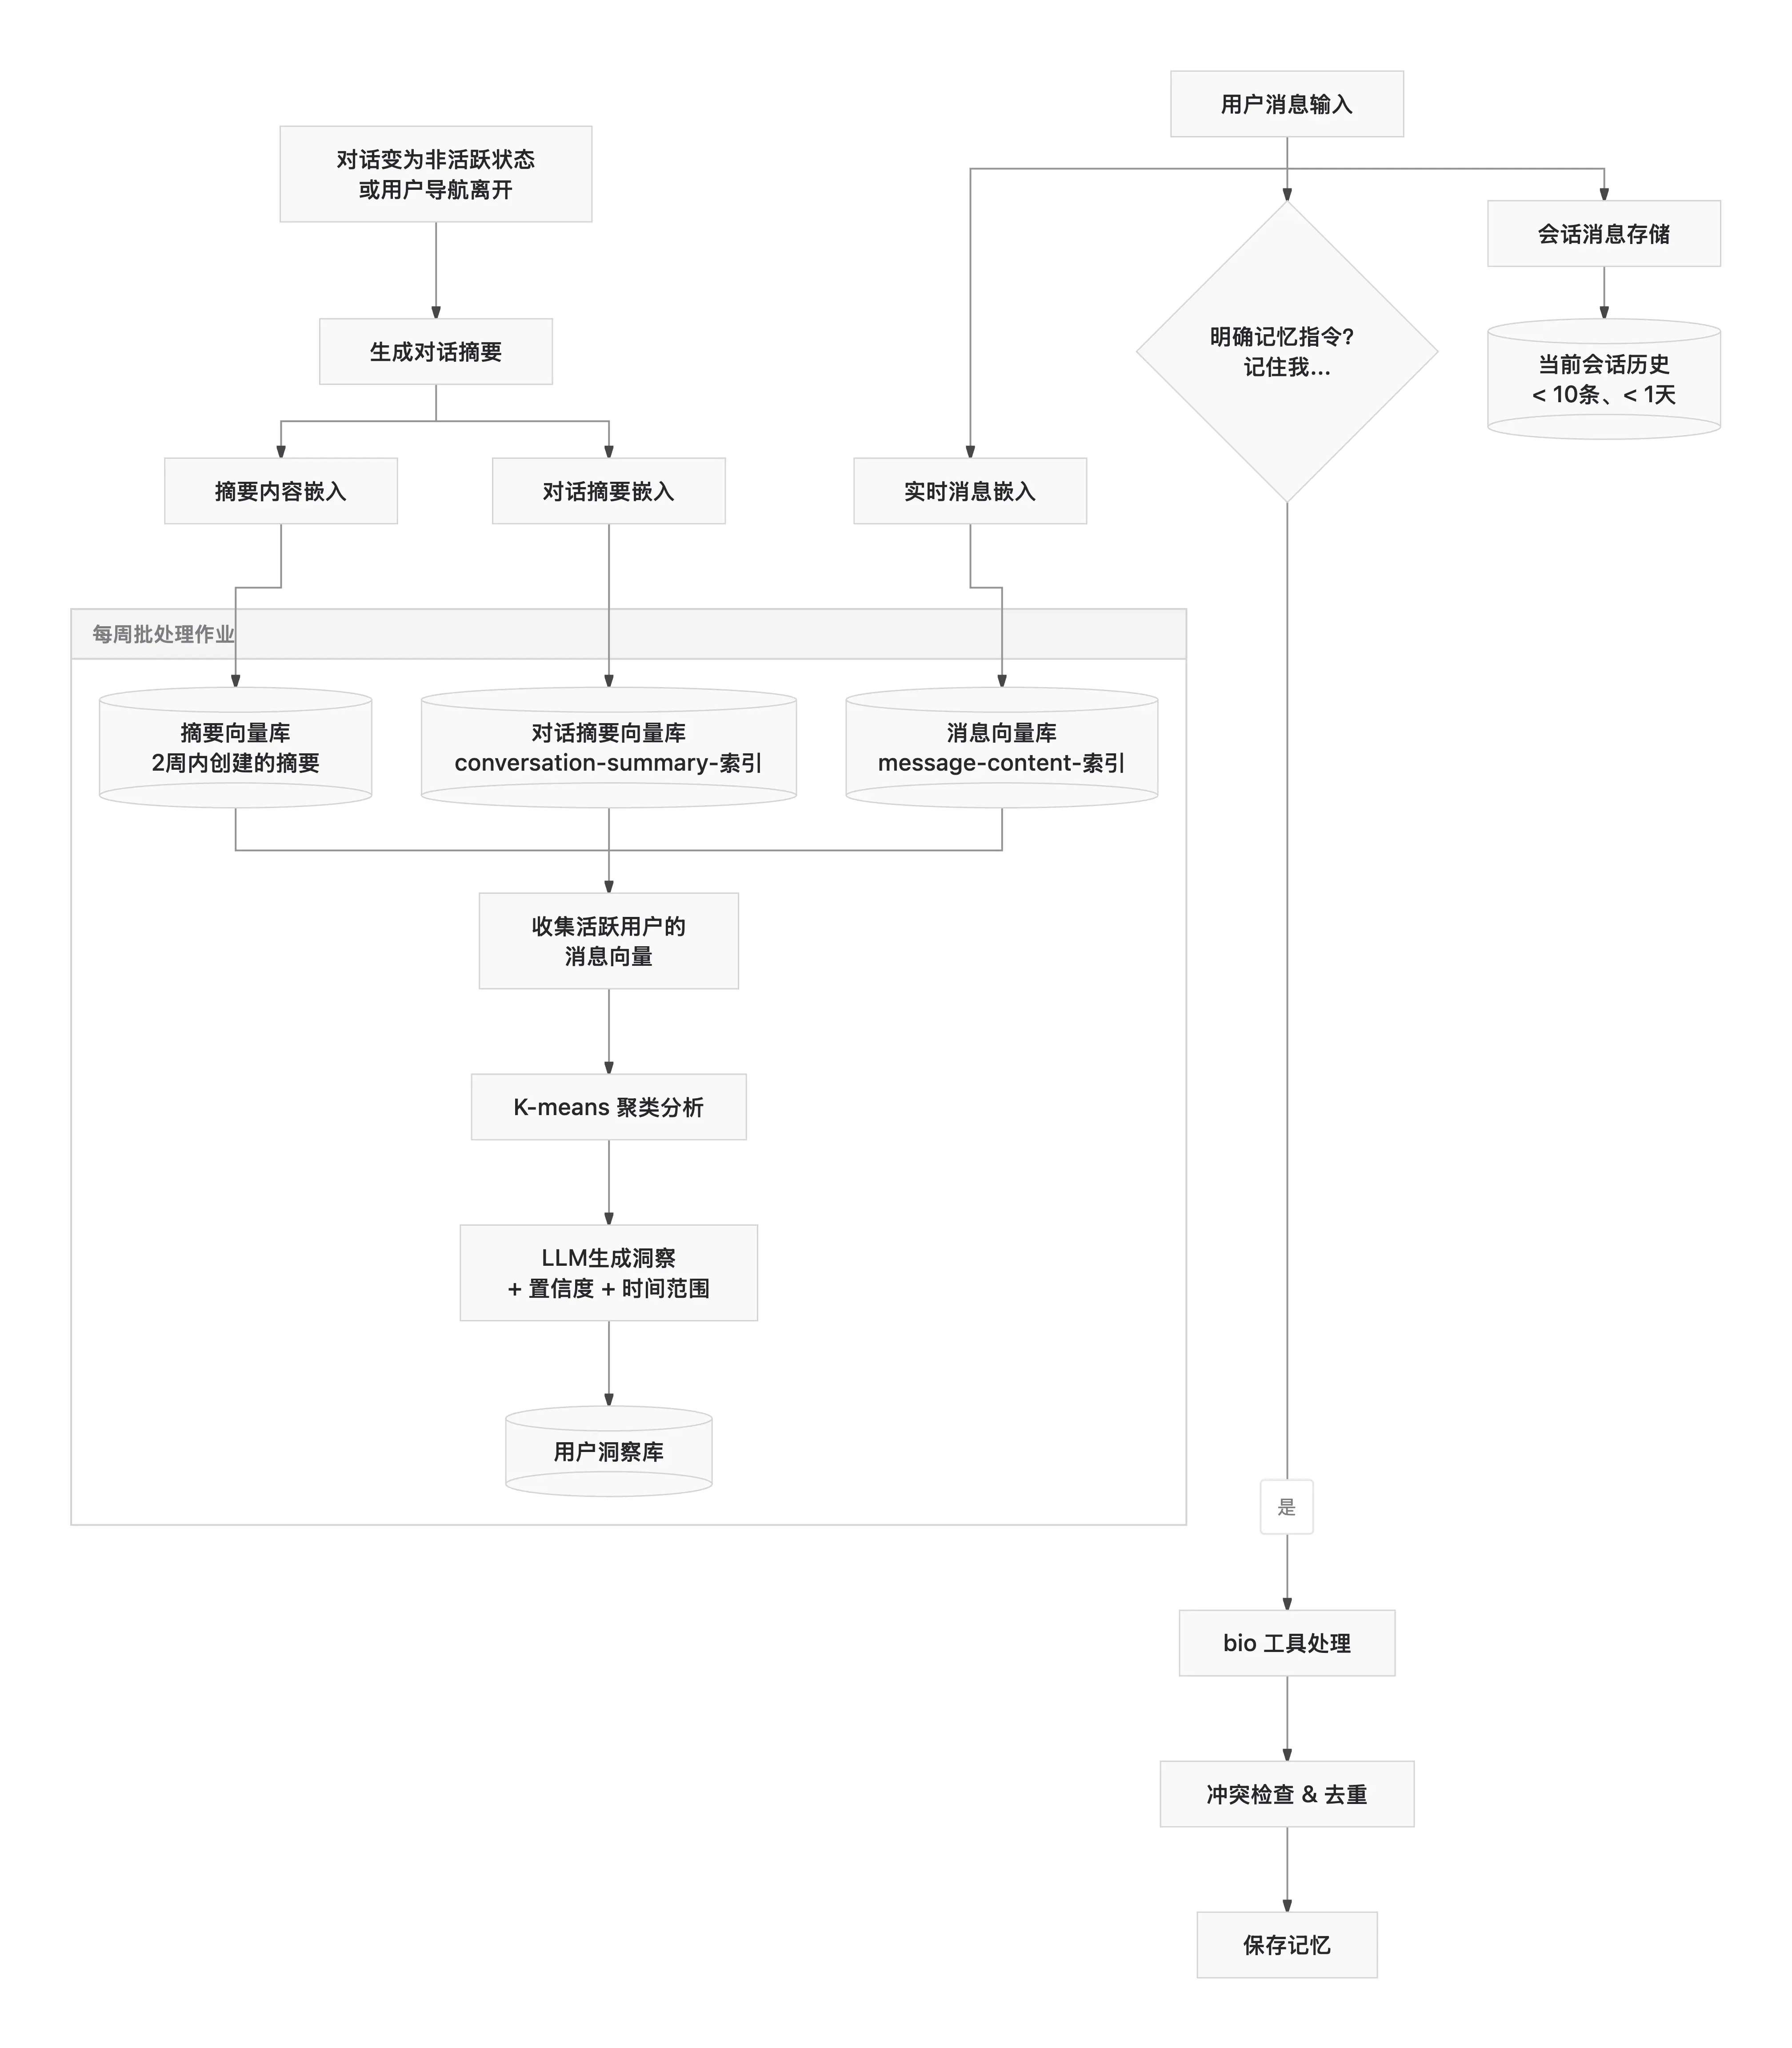
四层架构:保存记忆(用户显式控制)、会话历史(<10条短期记录)、对话历史(RAG智能检索)、用户洞察(自动行为模式识别)。用bio工具持久化信息,通过三重向量空间实现语义检索。
记忆入库流程
实时存储用户偏好→延迟处理对话向量→批处理生成用户洞察。消息内容、对话摘要、摘要向量库三个空间并行索引,K-means聚类算法自动提取行为模式。
检索流程
四源并行检索:直接读取保存记忆→获取会话历史→RAG向量搜索→调用用户洞察。关键是2周分界线:近期完整内容+远期摘要信息,实现精准个性化回应。
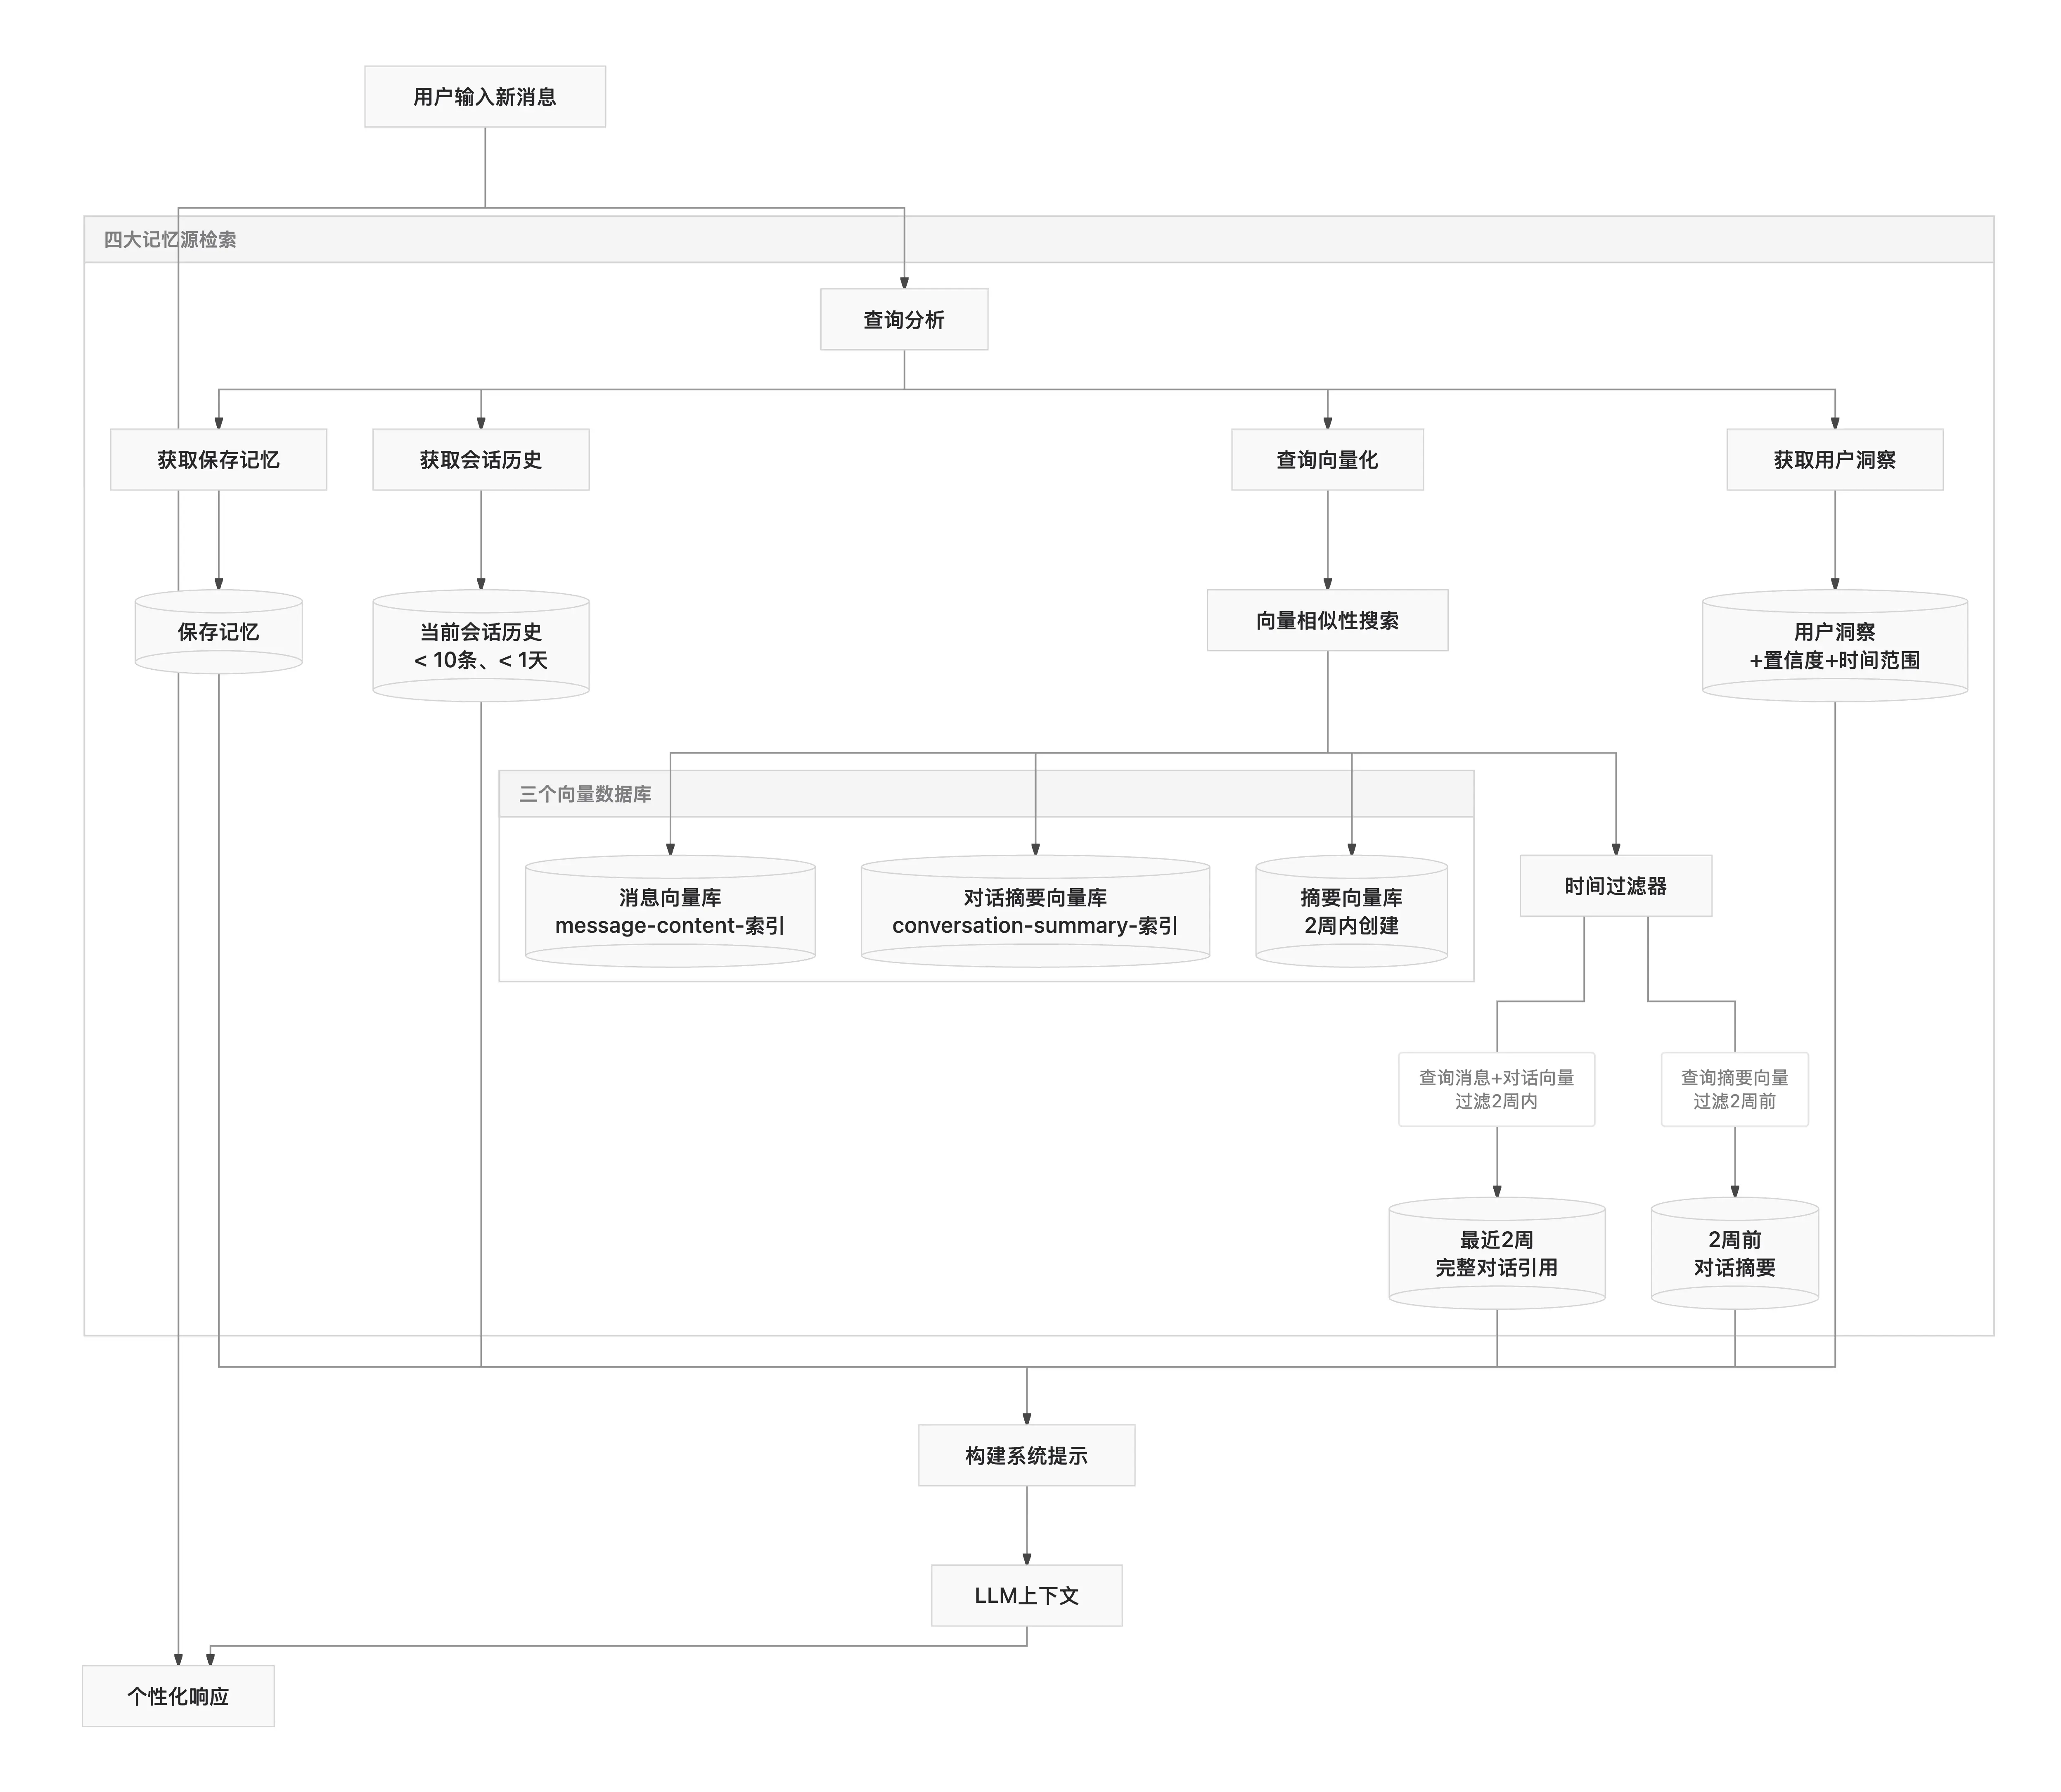
ChatGPT 的“多层记忆堆栈”给了什么启示?
- 即时—延迟—批处理 三段式管道
- 2 周分界线:近域全文、远域摘要,各占一套索引,既节省 token 也保证回忆粒度。
- 冲突检测 & 置信度:洞察带时间范围和置信度;过期或矛盾的记忆可被淡化。
- 用户可见、可控:随时 “请忘记...” 或关掉 memory 模块,隐私与体验两不误。
这一架构让 ChatGPT 得以同时满足即时上下文、长期个性化与隐私可控——而这恰恰是 MCP/第三方工具们尚未补齐的短板。
结语
把 AI 记忆做深,不是一句 “support memory=true” 的开关,而是一整条数据→结构化→抽象→检索→冲突管理的链路。
- MCP让“插头”统一,但 “电压标准”(多层记忆调度)仍待补全。
- Windsurf、Augment、Cursor已迈出“自动采集”的第一步,却还没跨过“语义抽象”的门槛。
- ChatGPT用四层堆栈给出了可行样板——也是未来各类 AI 平台需要追赶的方向。


