AI 写代码,什么语言最靠谱?
最近半年,我开新项目,后端默认 Node.js 或 FastAPI,前端 React + Next.js。Python 和 JavaScript 资料那么多,AI 写这两种应该最顺手吧?
腾讯 AI 团队的  autocodebenchAutoCodeBench 测试结果让我意外。
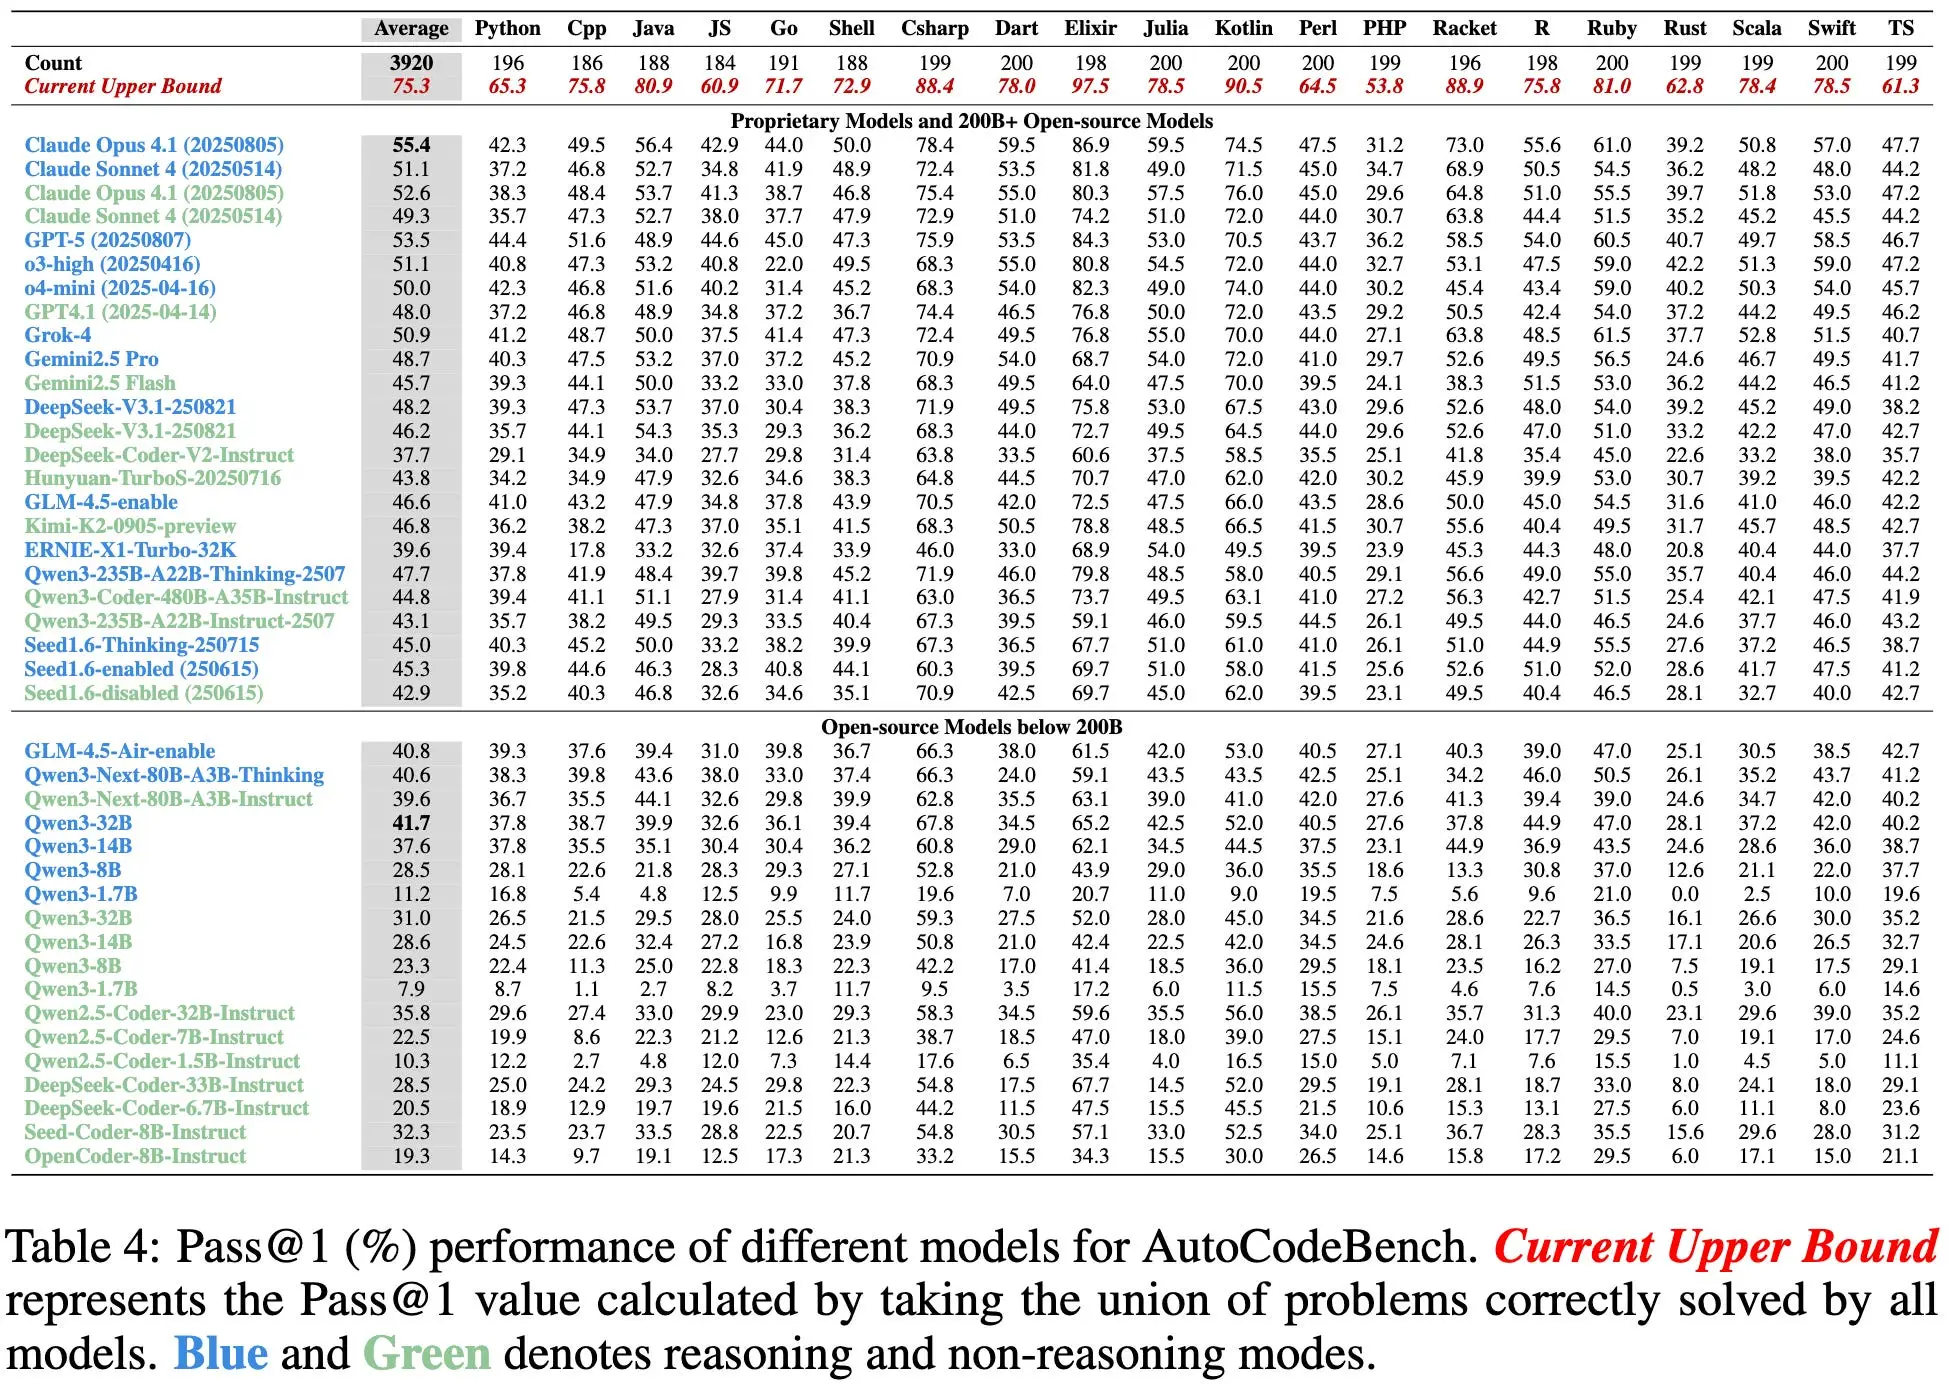
3,920 道题,20 种语言,30 多个模型。排名靠前的是 Elixir、C#、Kotlin、Racket;靠后的是 PHP、JavaScript、Python、Perl。 97.5% 的 Elixir 题目被至少一个模型解出,所有语言里最高。
训练数据越多,模型表现越好?Python 和 JavaScript 数据量那么大,应该更强才对。但并不是。
训练数据量 ≠ AI 代码质量
Greg Olsen 在  thefuriousoppositesGrace Hopper's Revenge 里说得明白:结构比数量重要。 JavaScript 数据多,但跟模型架构不搭;Elixir 数据少,正好契合模型的工作方式。
为什么?
不可变性让 AI 能做局部推理。 Elixir 创始人  dashbitJosé Valim 举过例子:面向对象语言里,调用
project.updateVersion() 后,之前拿的 manager 对象可能已经被改了,因为对象有引用,任何方法都可能影响任何东西。Elixir 里,函数输入输出都是透明的,没有"隔山打牛"的事。AI 不用重建全局状态就能看懂函数在干嘛。模式匹配让数据结构一目了然。 LLM 本质上就是模式匹配。函数式语言把数据的"形状"直接写在函数参数里,正好对上 LLM 的强项。JavaScript 里
useEffect + useState + this 绑定的组合,得重建整个运行时状态才能理解发生了什么,因为这是 LLM 最不擅长的。Olsen 说得直接:"三小时调一个 React 组件,五层 stack trace 告诉你什么都没发生。错误在
useEffect 里。到底哪个 useEffect?"生态系统统一。 Elixir 只有一个构建系统、一个格式化工具、一套标准做法。LLM 看到的模式是重复的、一致的。JavaScript 生态上千种变体,例如 Webpack/Vite/Turbopack、React/Vue/Svelte、npm/yarn/pnpm,LLM 在这种碎片化环境里容易懵。Revelry 的  revelryStuart Page 算了笔账:Elixir 标准库约 120 个核心模块、2000 个公共函数,Python 大约 15,000 个。表面积越小、一致性越高,混乱越少。
稳定性有价值。 José Valim 提过常被忽略的点:Elixir v1.0 是 2014 年发布的,12 年后还是 v1.x;Phoenix 框架也停在 v1.8。十年前写的 Elixir 代码现在还能跑。训练数据里没有"什么能用、什么不能用"的杂音。其他语言同一时期经历多次 breaking changes,模型学到的不仅有正确写法,还有一大堆已经过时的写法。
这不是说函数式语言就赢了。Olsen 指出 Rust 虽然显式、有类型、带函数式特征,基准测试表现却很差,因为借用检查器要求全局推理生命周期,这正是 LLM 的短板。TypeScript(47.2%)比 JavaScript(38.6%)高约 9 个百分点,类型系统有帮助,但两者还在下半区。
可以看出,"是否函数式"不是重点,真正的变量是 语义是否局部可见、状态变化是否显式、约定是否统一、工具链反馈是否快准。
一个开发者的实验
理论说完,看实践。Steve Clarke 做了 x对照实验:让 Claude Code 用同一份产品规格,在五个技术栈里做同一个 UI,包括取景器、AI 建议卡片、语音命令、条形码扫描。
结果:
- React + shadcn/ui:第一遍功能完整,没运行时错误
- Rails + Hotwire:意外地好,Ruby + HTML 的组合 AI 很擅长
- Rails + Inertia + React:同样优秀,第一遍过
- Rails + Inertia + Vue:改了三遍还是不达标,手写组件不用组件库,用 emoji 代替图标,CSS 碎了,好几个运行时错误
为确认是 Vue 的问题,Clarke 做了控制实验:同一个 Inertia 后端,同一路由,前端从 Vue 换成 React。结果立刻变好,第一遍过,零错误。唯一变量是前端框架。
但结尾有意思。Clarke 最后选了 Hotwire,虽然他不喜欢这风格。他 22 年 Rails 经验,深夜 11 点出问题的时候,他需要能看懂和调试代码。他总结出一个实用公式:
最佳组合 = 你自己擅长的技术 × AI 写得好的技术 × 实际解决问题的技术
"AI 写的是屎山"
推特上最近有场激烈讨论。一派说 AI 写的代码可读性差、命名乱、抽象层级不一致。另一派说 AI 代码不需要可读性,有 bug 就烧 token 去修。
两派说的不是一回事。
说 AI 写屎山的人,心里想的是"人写→人读→人改"的范式。按这个标准,AI 生成的代码确实不符合人类工程实践。
说代码不需要可读性的人,心里想的是"AI 写→AI 改→人验收"的范式。如果维护者也是 AI,人类可读性就不是核心约束了。代码变成中间产物,像编译后的二进制文件,你不会去读
.o 文件,只验证行为对不对。分歧的本质是:你把 AI 当工具,还是当同事?
两派都有道理,也都漏了东西。
"烧 token 修 bug" 这个模式有个隐含前提:闭环成立需要三个条件,分别是验证标准足够精确(你能用 spec/test/contract 说清楚"对"是什么),上下文窗口足够大(AI 能 hold 住修复所需的全部信息),以及修复不会引入新问题(或者测试能捕获新问题)。
现实里:边界清晰的后端 API 和纯逻辑层,这三个条件基本成立,TDD/BDD/contract testing 能撑起闭环。但状态复杂的前端 UI 或跨模块的架构问题,目前还有明显的缺口。
说"AI 写的代码可读性差是因为它注意到了更多内容"的人,也得面对一个工程现实:复杂度永远要付利息。 不管是人类还是 AI,Kernighan 定律的底层逻辑没变,越复杂的代码,修复成本越高。AI 当前上下文窗口有限且没有持久记忆,充满隐式状态和全局依赖的代码会让修复成本指数级上升,哪怕修复者就是 AI 自己。
关键在验收
所有这些讨论最后都指向一个点,验收。
控制 AI 怎么写代码其实没那么重要,后端项目用好 Coding Agent 的关键在于定义好什么算"对"。人类写好约束、划好边界,包括 spec、TDD、BDD,其余交给 Agent 自主完成,人只负责引导和监督。
这正是 Grace Hopper 75 年前的预言。她构想第一个编译器时,想象的是从英语直接到机器码,中间实现层不是人类该操心的。75 年后,我们终于能按她的愿景工作了。
Greg Olsen 在 Grace Hopper's Revenge 里改写了 Abelson & Sussman 的经典名言:
"Programs must be written for people to verify, and only incidentally for machines to execute."程序必须是为了让人类验证而写的,执行只是顺便的事。
深层含义是:代码只是实现,软件工程的真正的承重墙是用英语写下的意图,包括需求文档、bug 报告、接口规范、审计日志。人类定义意图,人类验证结果,中间发生的一切都是实现。
几条线索串起来了:
- Grace Hopper 的预言:英语 → 机器码(人定义意图,机器实现)
- Kernighan 定律:代码要简单到你能调试它
- AI 时代的推论:验收标准要清晰到你能验证 AI 的输出
Kernighan 定律在今天的新解读
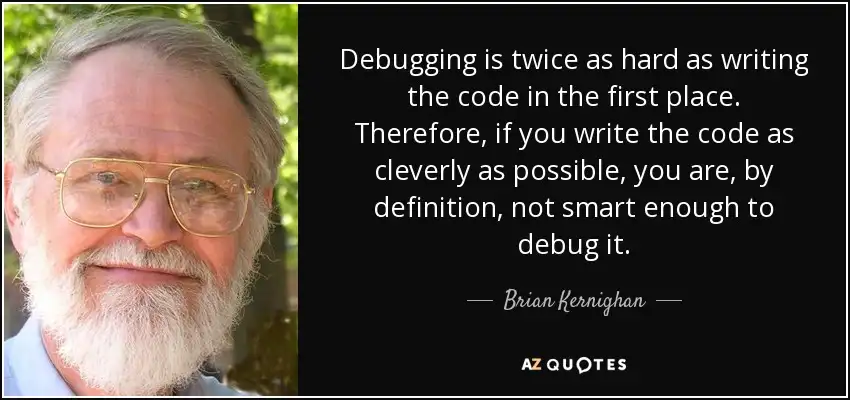
Kernighan 的原始版本:
调试比写代码难一倍。所以如果你写出了最聪明的代码,你就没有足够的聪明去调试它。
在 AI 时代,这条定律有了新的含义:
验证比生成难一倍。所以如果你定义了无法验证的需求,你就没有足够的能力去验收 AI 的输出。
这意味着工程能力的核心正在发生转移,从"写好代码"转向"定义好什么是对的"。写好的 spec 比写好的代码更重要;设计可测试的接口比实现接口更重要;定义边界和契约比填充实现更重要。
过去我们用咖啡当燃料写代码,现在用电力和 token 当燃料。代码确实在变便宜。但定义什么算"对"的能力,正在变得前所未有地贵。
AI 会演化出什么样的工程结构?
我刷推看到有人在讨论:AI 会演化出类似人脑的工程结构吗?
我的判断是:AI 会演化出适合 AI 的工程结构。
人类发明模块化、分层架构、设计模式,本质上都是在弥补人脑工作记忆(约 7 个 chunk)的局限。AI 的局限不同,它是上下文窗口有限且没有持久记忆。
所以 AI 友好的架构可能是这样:
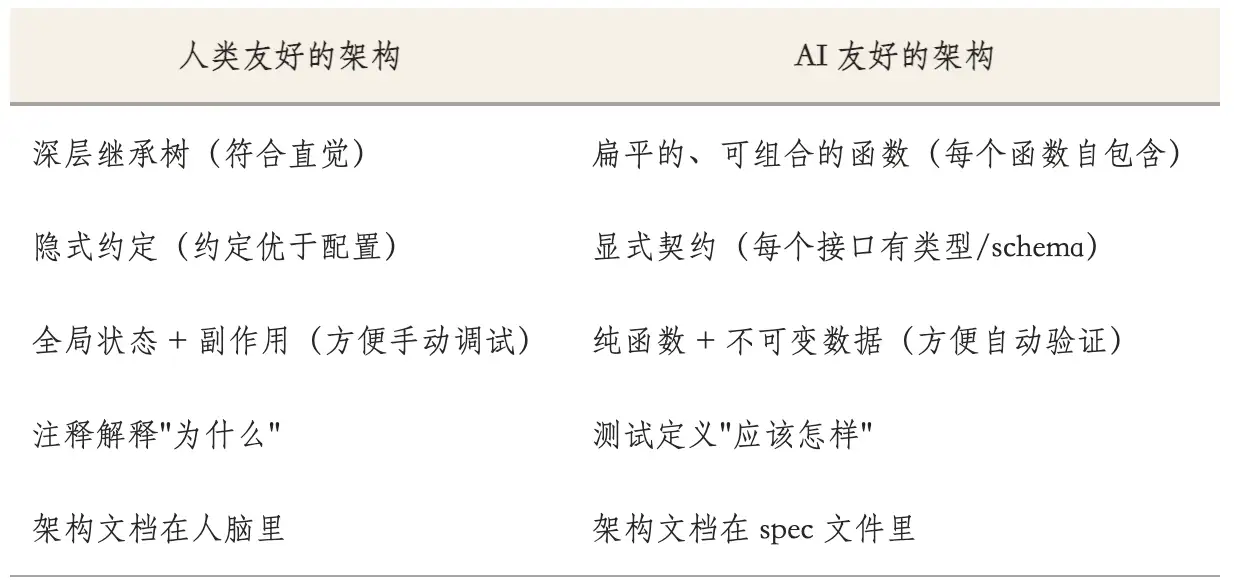
AI 友好的架构和函数式编程的主张高度重合。这也呼应了 AutoCodeBench 的测试结果,Elixir、Racket 这些语言的设计特性天然就适合 AI 生成和验证。
Olsen 引了句话:"那些坚持 Haskell 和 Erlang 的极客们在语言设计上并没有错。他们只是太早了。McCarthy 最早:1958 年的 Lisp。"
实际的工作流正在变成这样
TDD/BDD/contract testing 不再只是最佳实践了 ...
说了这么多,但我的建议是很克制的:
不需要立刻抛弃 Node.js/React。 但要意识到 AI 在这些栈上的输出质量有上限,需要更多人工审查。不管用什么栈,函数式风格的代码(纯函数、不可变数据、显式数据流)都能让 AI 写出更好的代码,即使在 JS/TS 里也一样。至少坚持用 TypeScript,类型系统确实有帮助。
如果在评估新语言, Elixir/Phoenix 值得认真考虑,尤其是高并发和实时功能的场景。José Valim 说得好:Elixir 的低运行复杂度意味着你往往只需要 Phoenix 和一个数据库,不需要 Redis、RabbitMQ、Amazon Lambda,这些在语言运行时内部就解决了。当 AI 只需要调试一个组件而不是五个时,成功率自然更高。
如果想验证这些发现, Steve Clarke 的方法值得借鉴:挑一段真实需求,让 AI 在两三套候选栈里各实现一遍,记三件事,分别是第一次能跑的概率、修到能上线的迭代次数、你 code review 时能不能快速判断对错。
最重要的一点: 不管选什么语言,把精力投在验收体系上,包括写好 spec,写好测试,定义好接口契约。这才是 AI 时代开发者最稀缺、最不可替代的能力。
The End
Grace Hopper 预见了从英语到机器码的直接翻译。Kernighan 警告我们别写出超出自己调试能力的代码。75 年后,他们的洞察在 AI 时代以一种意想不到的方式验证了:不要让你的需求复杂到你无法验证 AI 的输出。
NVIDIA 用 Grace Hopper 的名字命名了驱动我们所有 AI 进步的 nvidia芯片架构。以她命名的机器,终于让我们看到了她当年看到的东西。
Reference
[1] AutoCodeBench: Multilingual Code Generation Benchmark. Tencent AI Lab Hunyuan. https://autocodebench.github.io/
[2] Olsen, G. (2025). Grace Hopper's Revenge: What the machines teach us about our software tools. The Furious Opposites. https://www.thefuriousopposites.com/p/grace-hoppers-revenge
[3] Valim, J. (2025). Why Elixir is the best language for AI. Dashbit. https://dashbit.co/blog/why-elixir-best-language-for-ai
[4] Clarke, S. (2025). Your AI Doesn't Write Every Framework Equally Well. https://x.com/SevenviewSteve/article/2019601506429730976
[5] Page, S. (2025). Which Language is Best for AI Code Generation? The answer might surprise you. Revelry. https://revelry.co/insights/artificial-intelligence/which-language-is-best-for-ai-code-generation/


