当代码产出变得廉价,怎么提高版本历史的可读性?
最近看开源项目 PR 会有一种疲惫感。你打开一个仓库,看到一个贡献者提交了几千上万行 diff。里面可能有有用的东西,也可能是一坨模型堆出来的噪声。最糟糕的地方不在于它多,而在于你很难判断它值不值得继续看。维护者被迫做一件很不经济的事:用自己的注意力,为别人用 AI 生成出来的代码补齐上下文,那为什么不自己 vibe coding 呢?
模型能力越强,这个趋势越明显。一个人可以在半天里生成过去两周的改动量。代码量上去了,协作却没变得更轻松,很多团队反而更难协作。因为协作的瓶颈从产出转移到了理解与验证。过去大家争的是实现速度,现在争的是谁来承担审计成本。
Code is cheap, show me your prompts
这里有个微妙但关键的变化。越来越多的真实劳动不再发生在代码本身,而是发生在和模型的往返对话里。你提出问题,模型给方案,你改约束,模型再迭代,你在某一轮决定了取舍。然后代码才落到仓库里。对话里包含动机、边界、被否决的替代方案、踩过的坑、验证方式。diff 只能告诉你改了什么,无法稳定地告诉你为什么这么改。模型越强,这个缺口越大,因为它能把改了什么快速堆得很高,或者说 AI 写出的代码本身可读性就很差...
如果协作实践不变,会出现一个很可预期的结局。代码提交越来越像扔进来一包未经标注的零件,review 越来越像开盲盒。维护者会用更硬的门槛自保,团队会用更强的流程自保,开源会用更冷的态度自保。大家不会真的讨厌贡献者,大家讨厌的是被迫无偿承担不确定性。
我去年 7 月在 advx 黑客松上就做了个强迫你提 PR 前,必须仔细思考填写这么一个表单,不要擅自把 review 的责任推给别人或者随意用自己的信誉给 llm 生成的内容做担保。
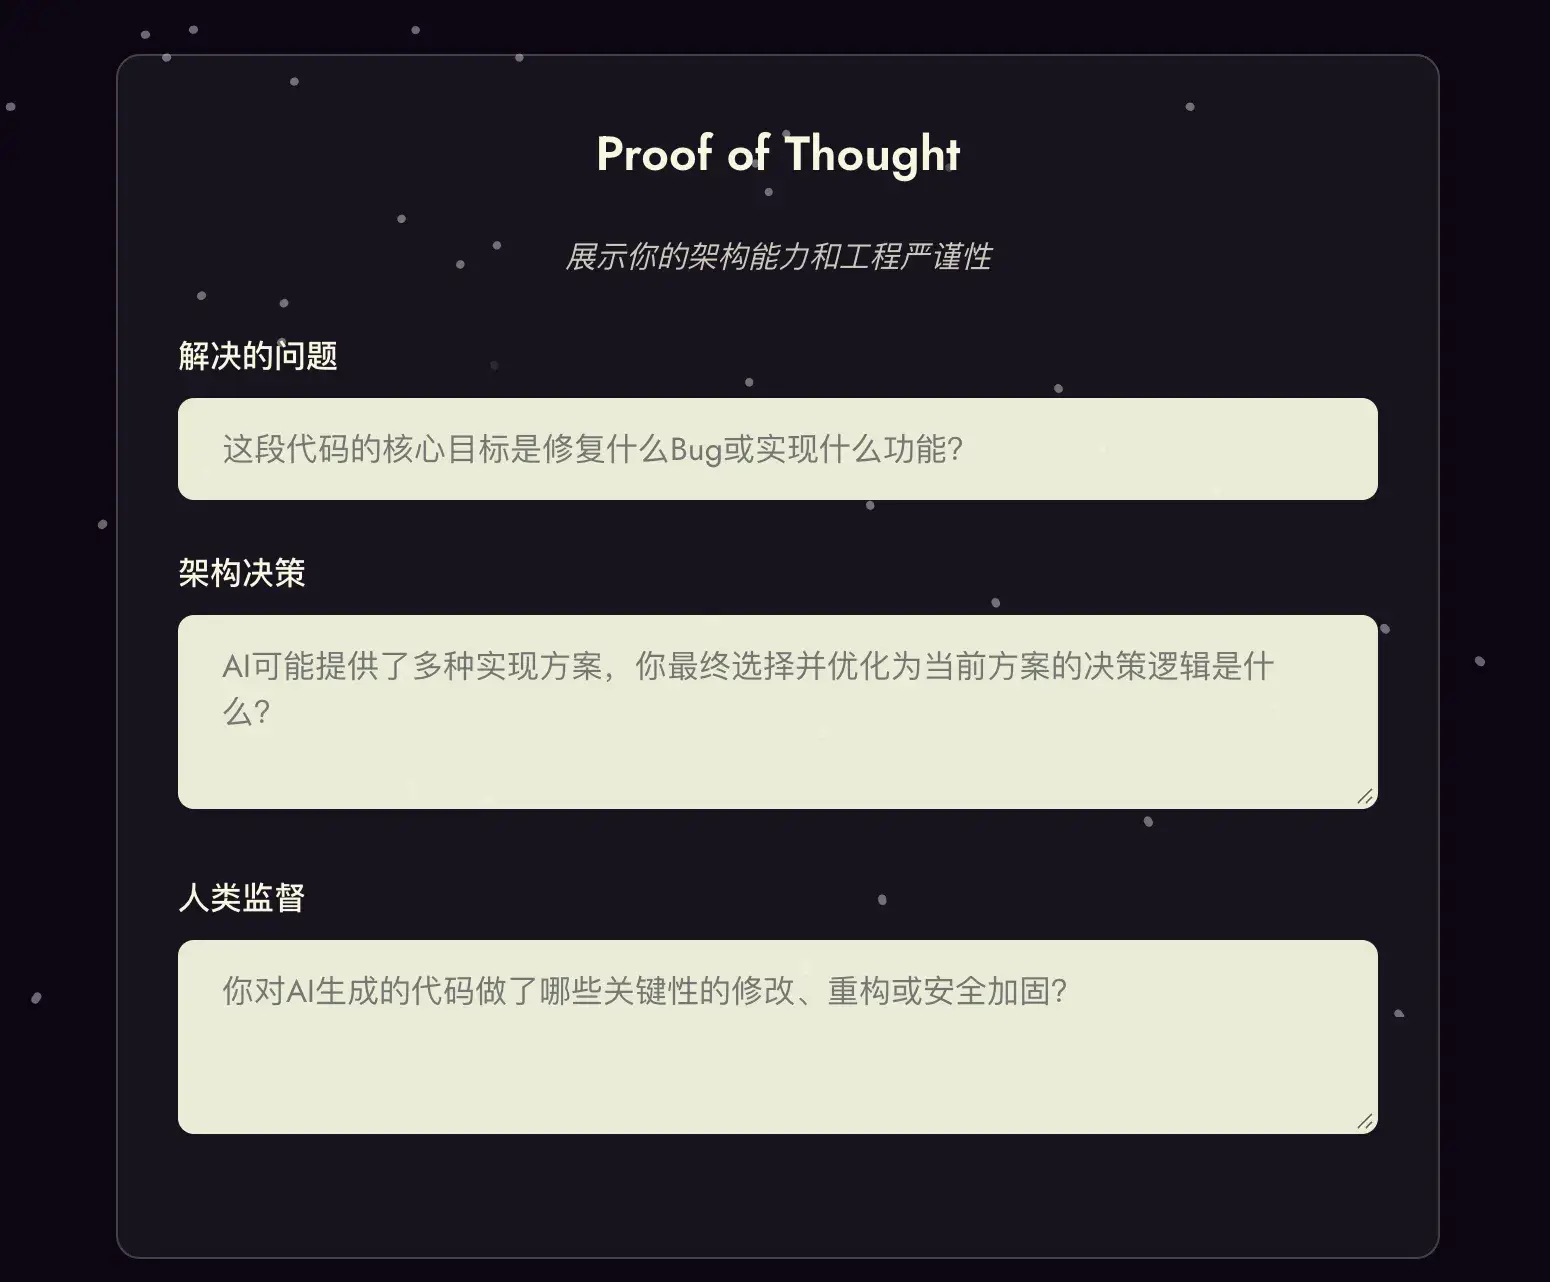
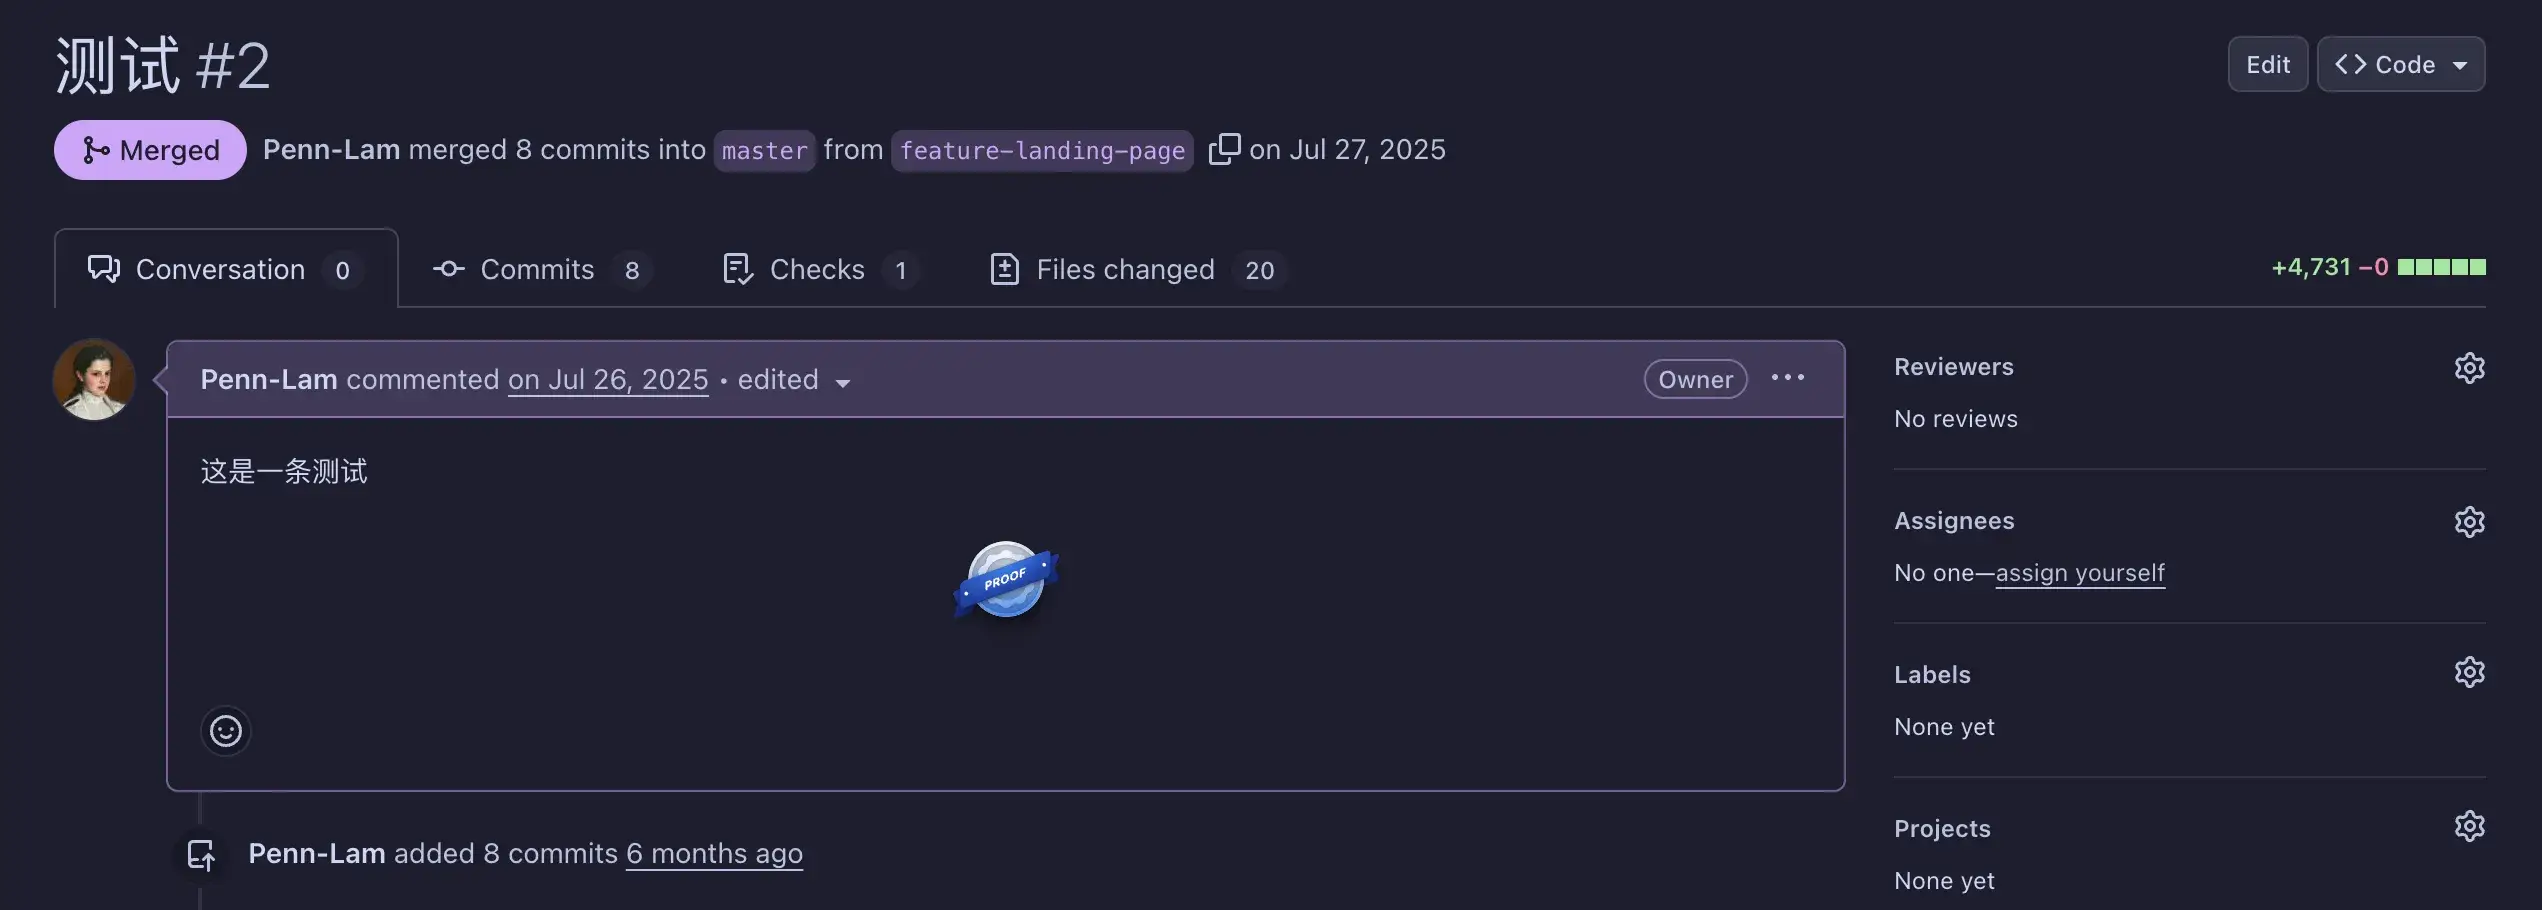
然后你的 PR 就会得到这么一个 badge,点击即可跳转看到你填写的表单。
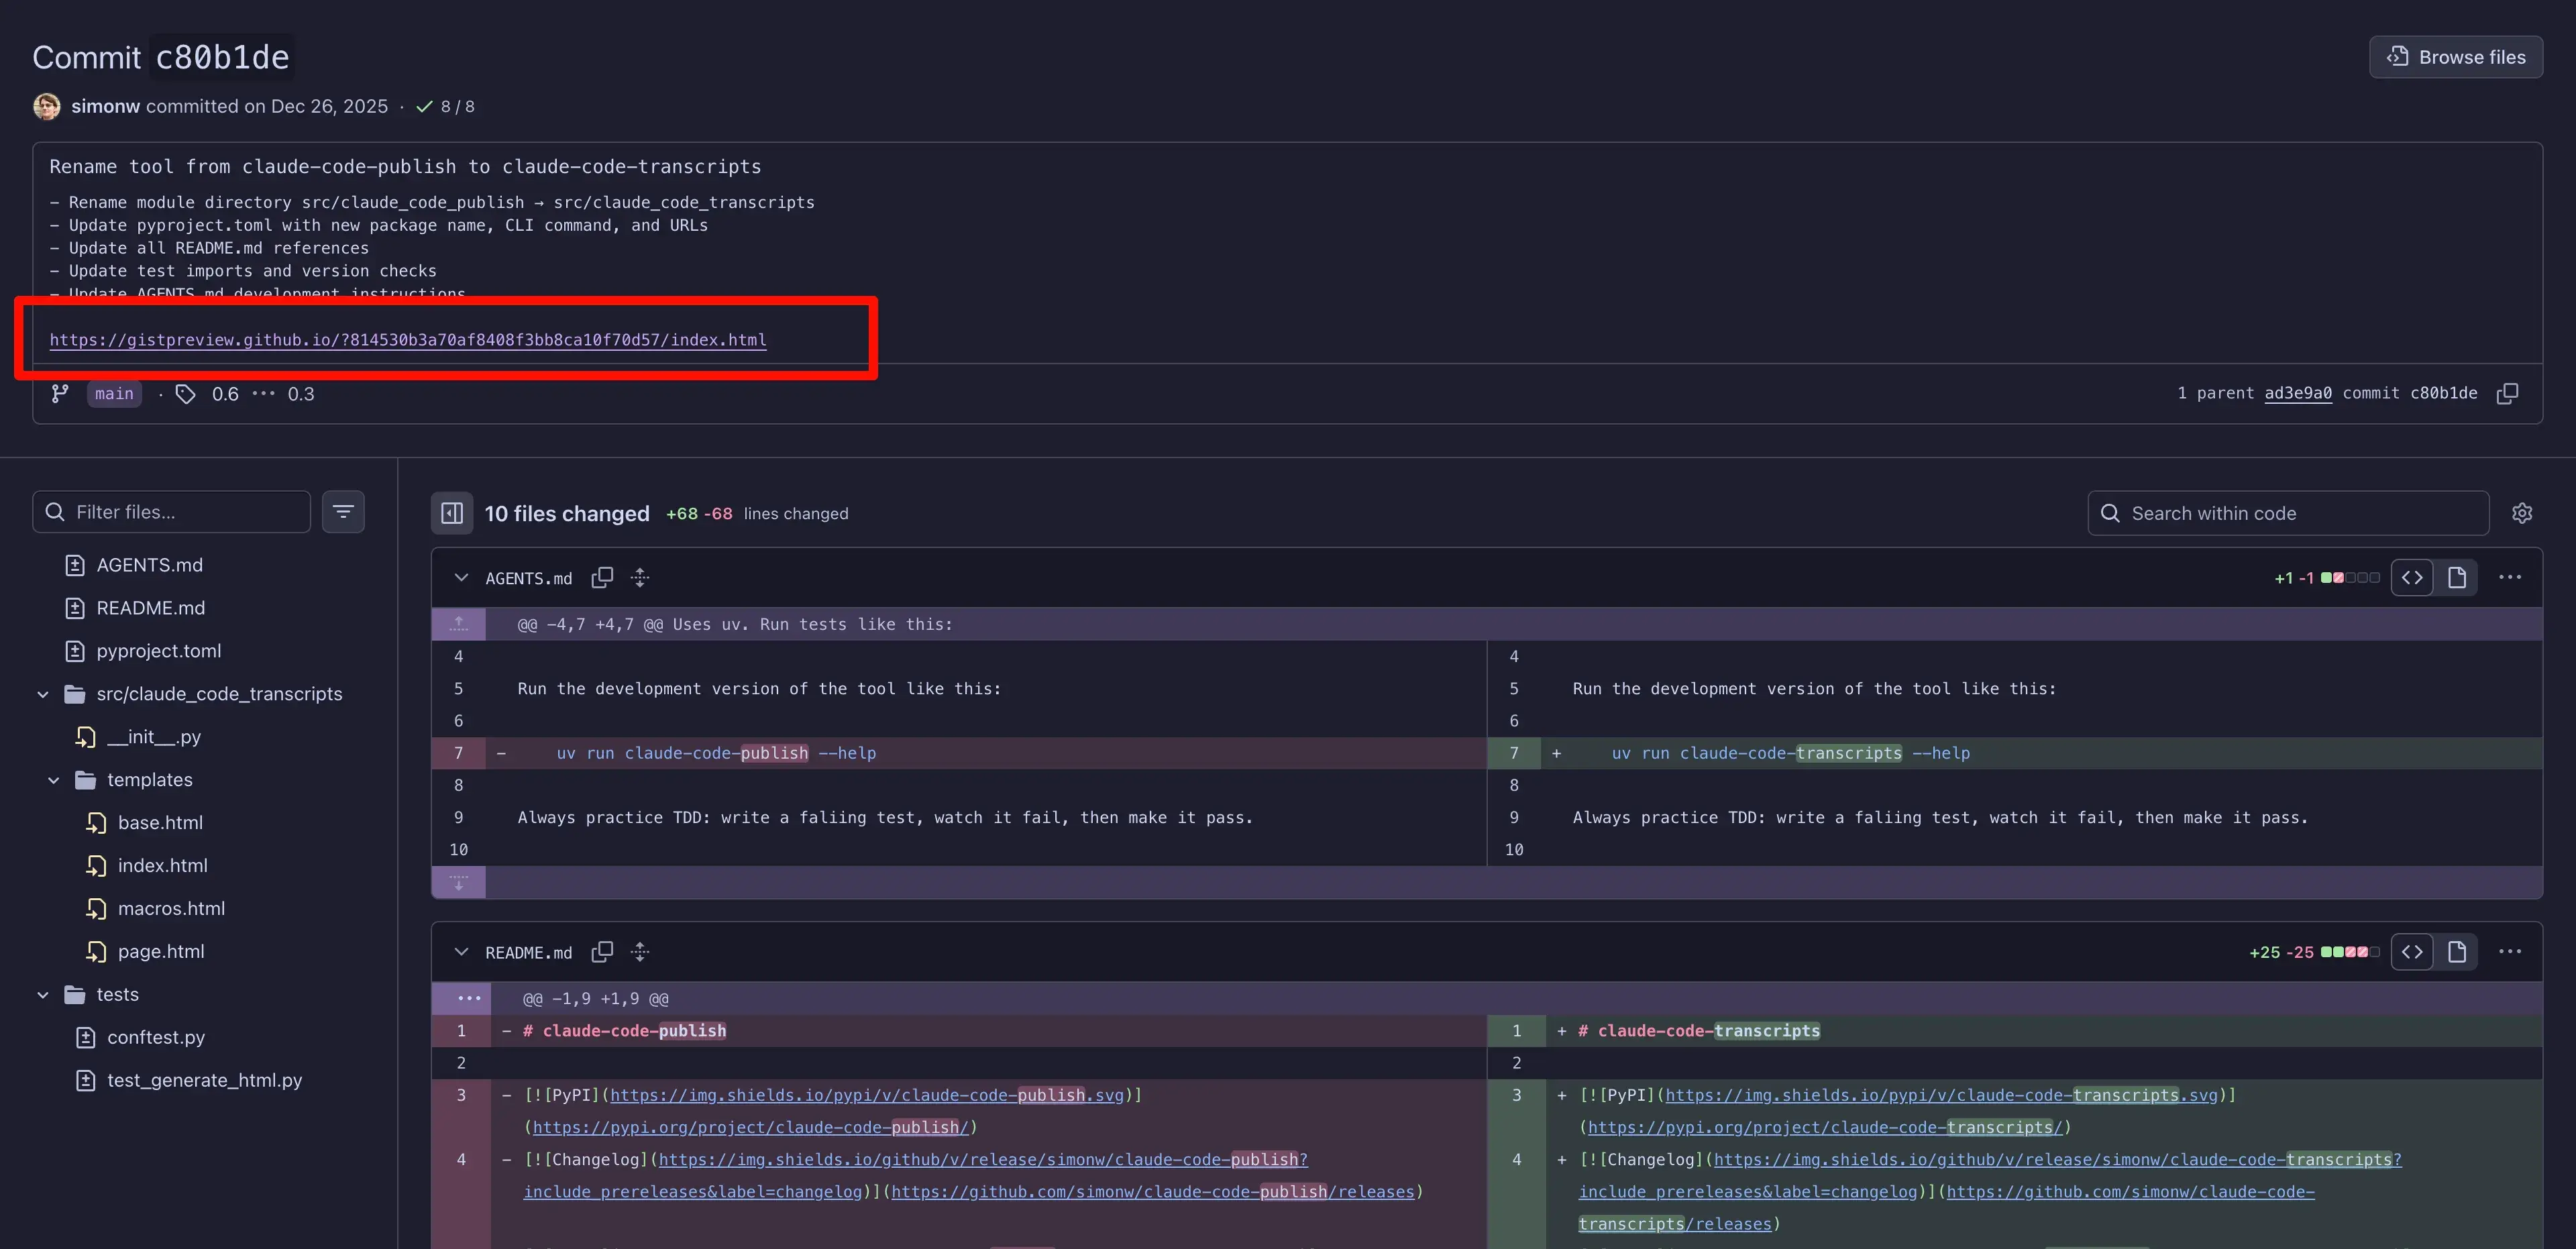
最近我在用 Simon Willison 写的 github小工具,它能把 Claude Code 会话整理成更适合阅读和分享的静态页面,然后给你一串 gist url,就可以附到 commit message 或者 PR 里。它解决的是证据链,未来任何人回看这段历史时,能直接看到当时的意图怎么形成,怎么落到实现上。
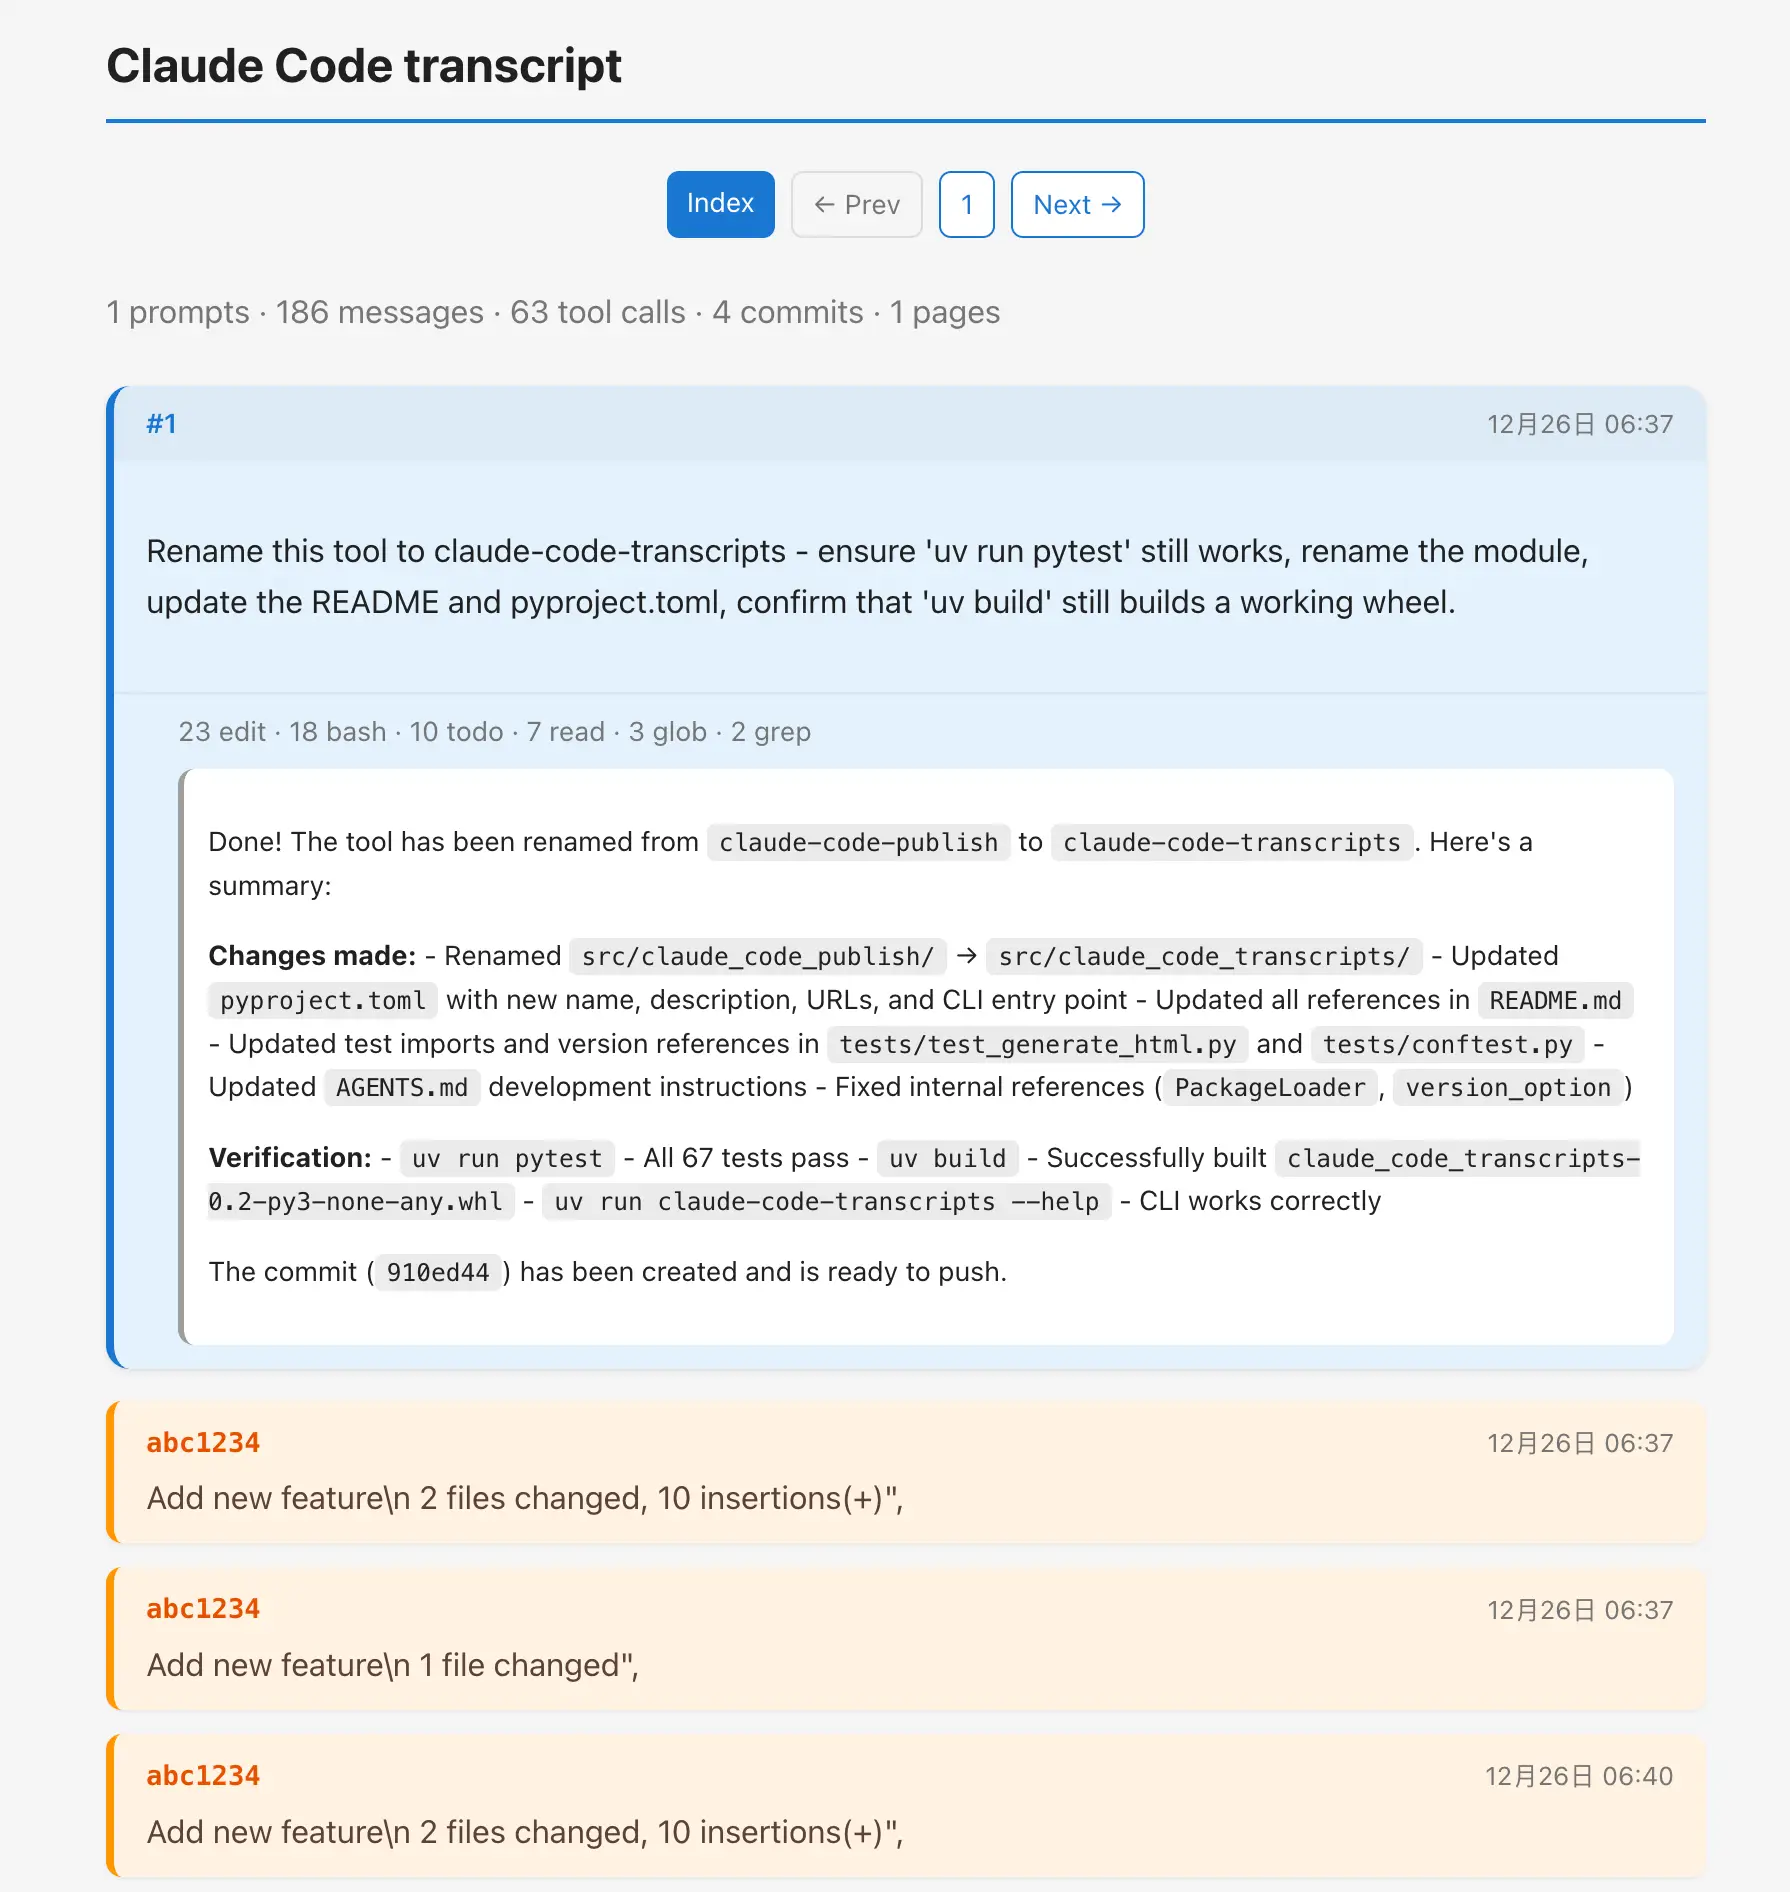
不过导出对话只是开头。真正的问题在于,我们需要一套更像样的协作界面和协作单位。Thoughts and Experiments 团队的这篇  xNarrative Version Control 给了一个很清晰的方向。

它从一个直觉出发:版本控制长期把 commit 当作最基本的叙事单位,LLM 时代这个单位开始失灵。原因很简单。commit 是快照,diff 是结果。对话才是过程。今天的工作过程越来越像写作,你起草,你改写,你推翻,你重新组织,再落成最终文本。我们却仍然只保存了最终文本的差异,不保存写作的过程。模型越强,过程越重要,因为过程里藏着取舍,取舍决定风险。
Thoughts and Experiments 他们想把“过程”重新放回默认视图。它设想的第一视图不是 commit 列表,而是一条时间线。一条能读的时间线。你看到的是叙事线程,改动之间通过对话和意图串起来。你能追踪一个点子从第一次被说出来,到几轮对话推演,再到代码落地。版本历史不再是一串孤立快照,它更像一段连续的创作记录。
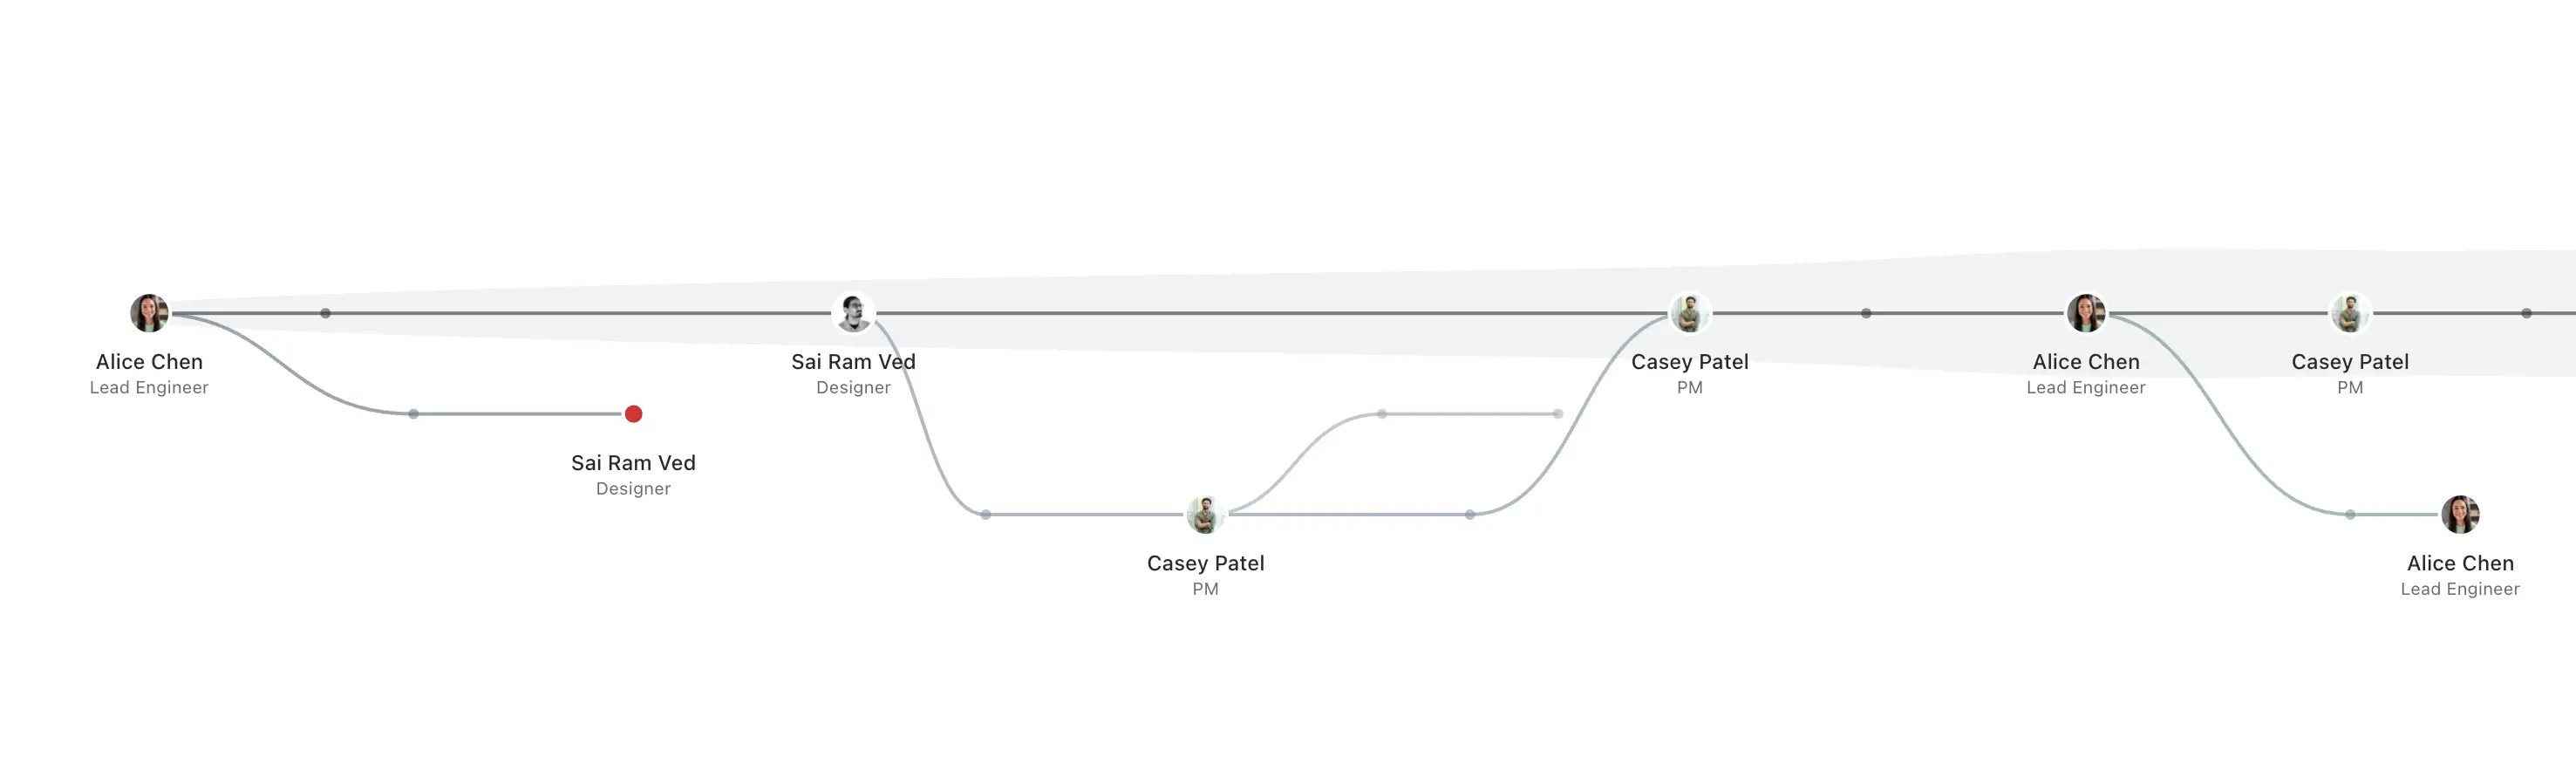
这条时间线还有一个很重要的设计原则,渐进展开。它明确反对把 commits、PR、raw diffs 混在同一层丢给用户。LLM 时代的变化量太大,信息噪声太重,人类会被淹死。它希望顶层先给抽象的里程碑,让任何角色都能理解项目在做什么。往下钻才看到更细的东西。管理者关心谁在做什么,为什么卡住。工程师才需要看具体对话片段、文件差异、测试信号。界面用层级把不同人的需求隔离开,减少互相折磨。
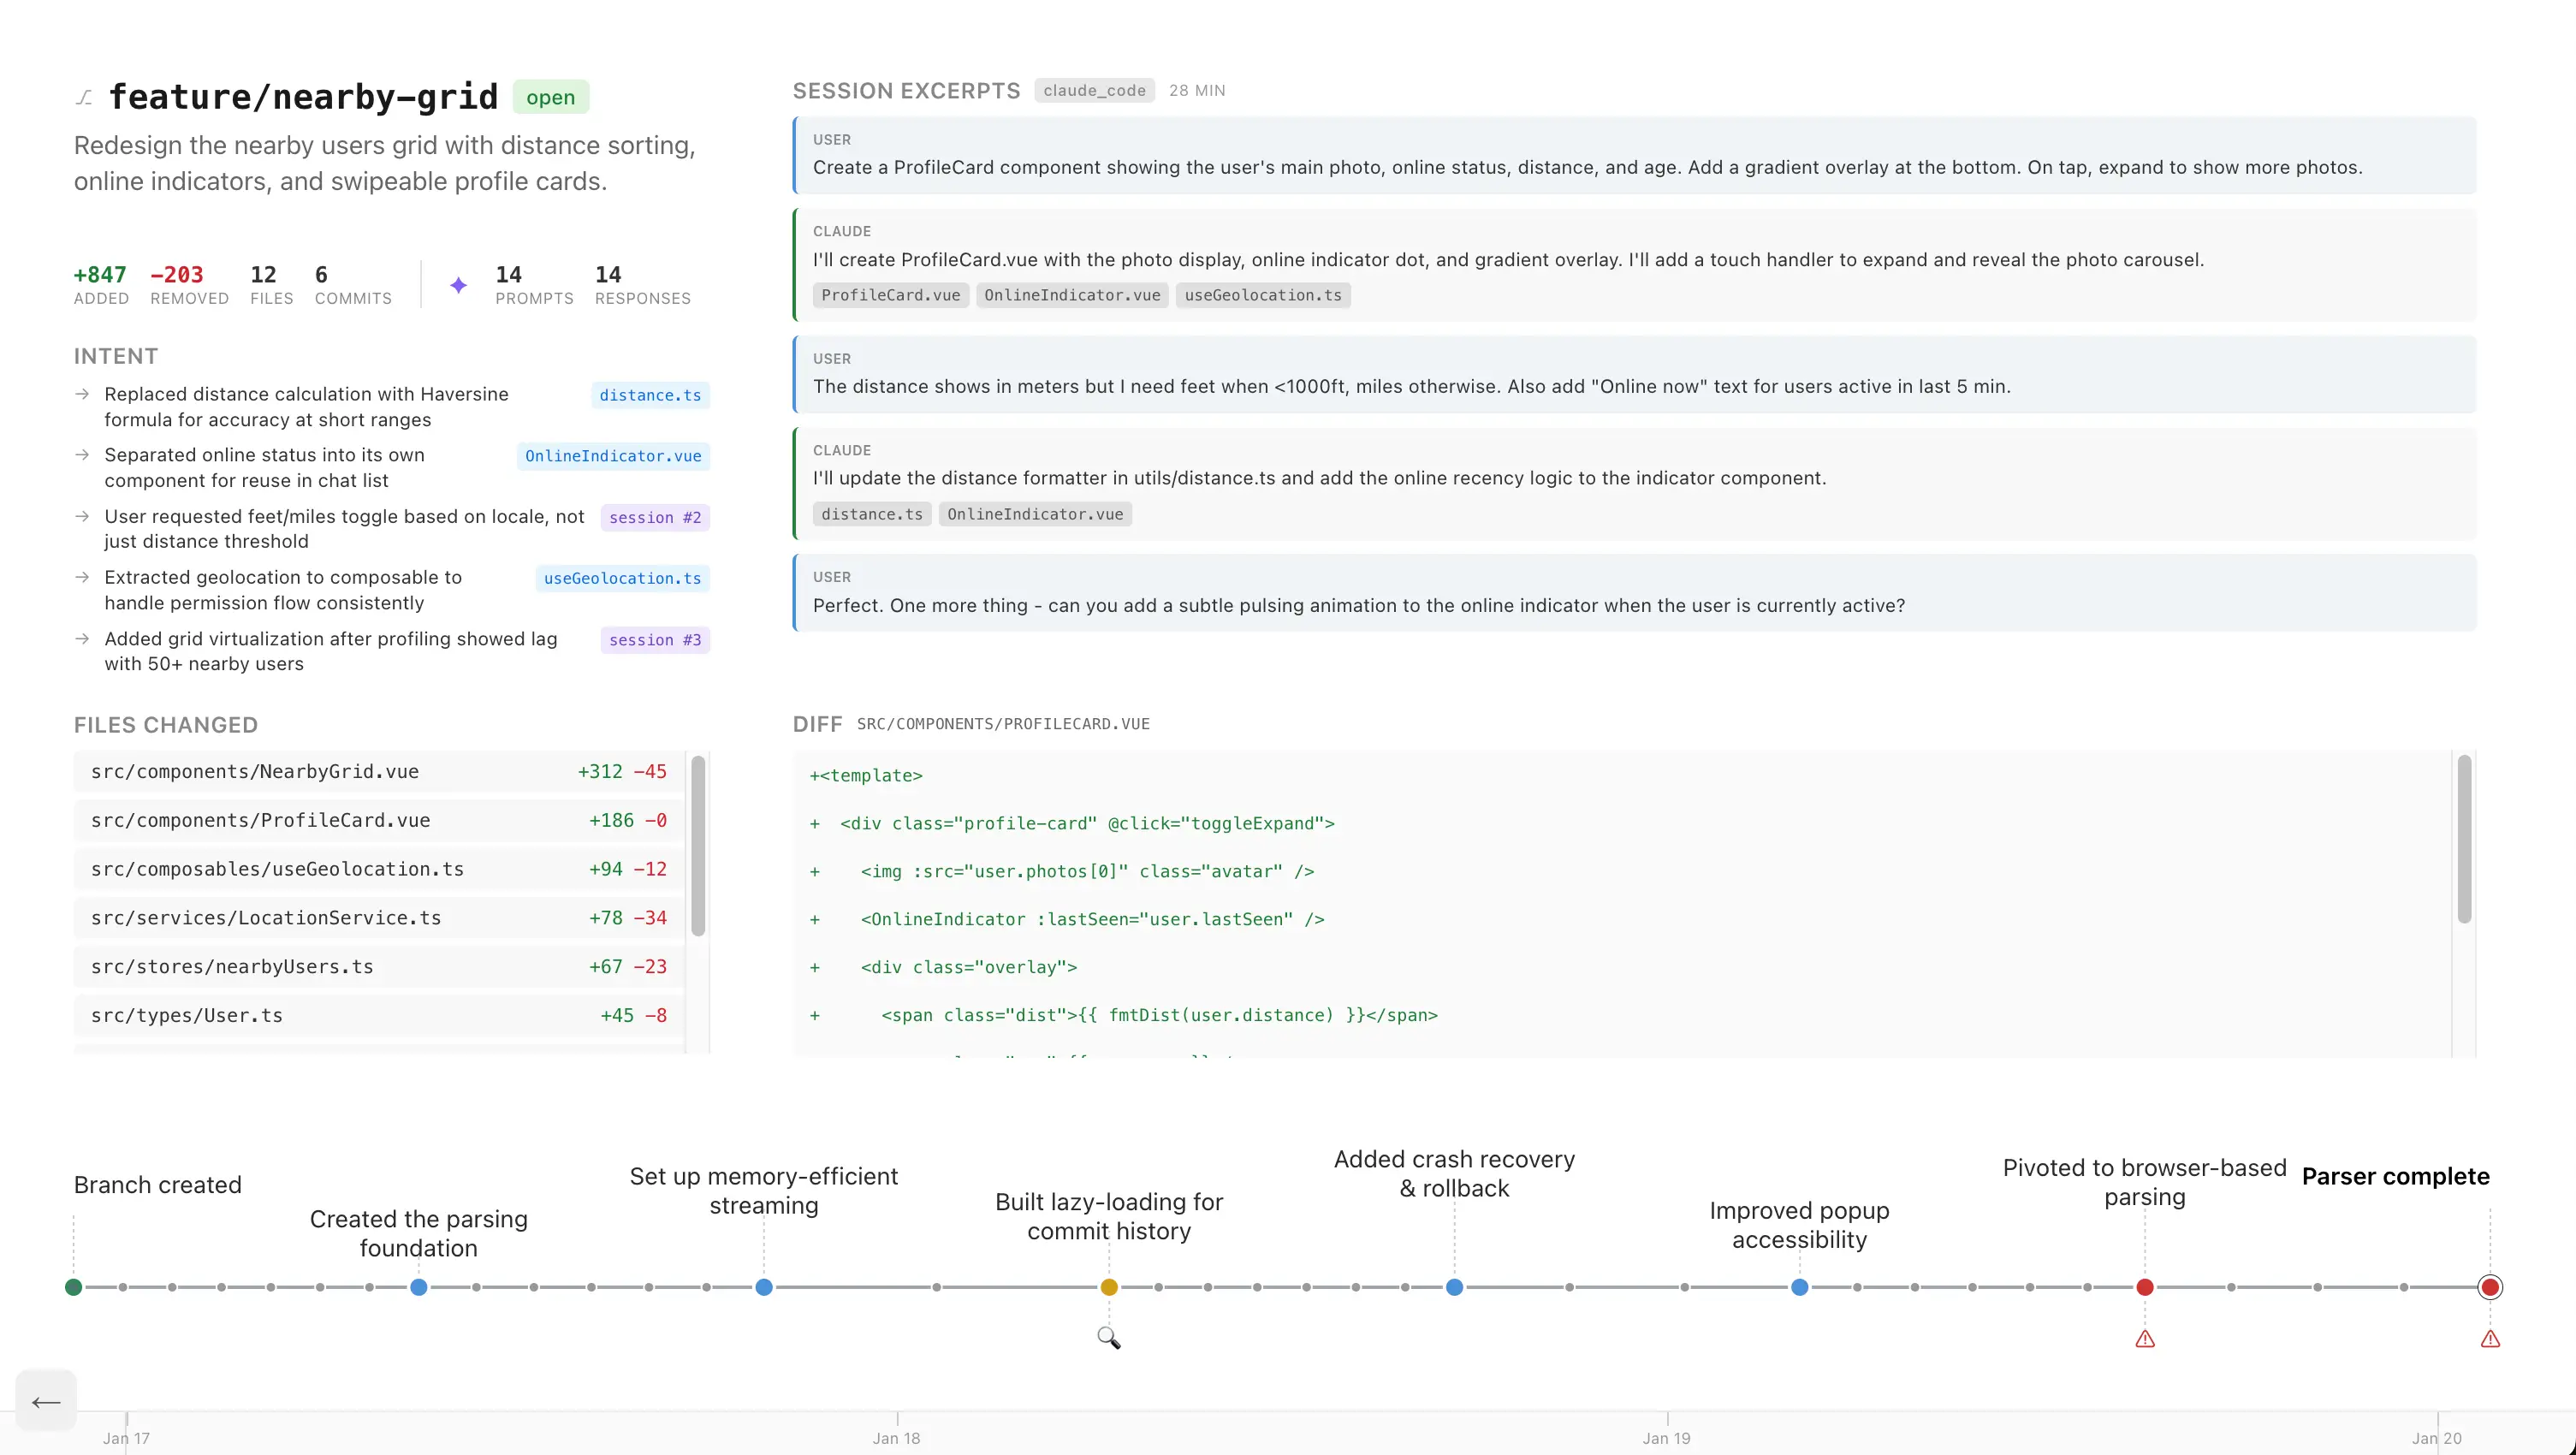
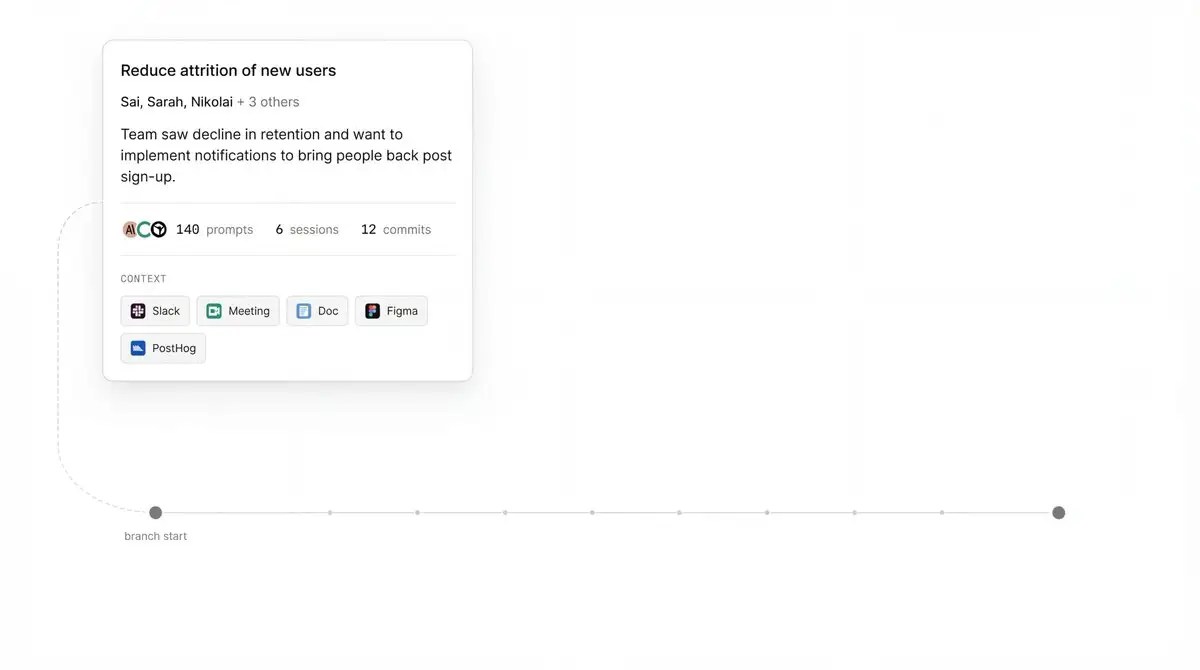
它还提出一个很现实的入口场景。点进某个分支,你看到的不只是最新 commit。你会看到这个分支背后和 LLM 往返了多少轮,以及一段非技术的解释,说明这条分支在实现什么。它把“分支”当作叙事容器,默认给你意图和上下文,而不是让你从 diff 里摸索。
在叙事节点上,它提出 AI session highlight 的概念。对话不是平均有用的。真正决定方向的往往是少数几轮:范围改变的那一轮,方案被否掉的那一轮,测试失败后重新定位问题的那一轮。它试图把这些关键节点高亮出来,点开就能看到对话摘录、受影响文件、对应 diff,以及附近是否跑过测试。这样你不必通读整段对话才能理解发生了什么,你沿着高亮节点就能把故事复原出来。
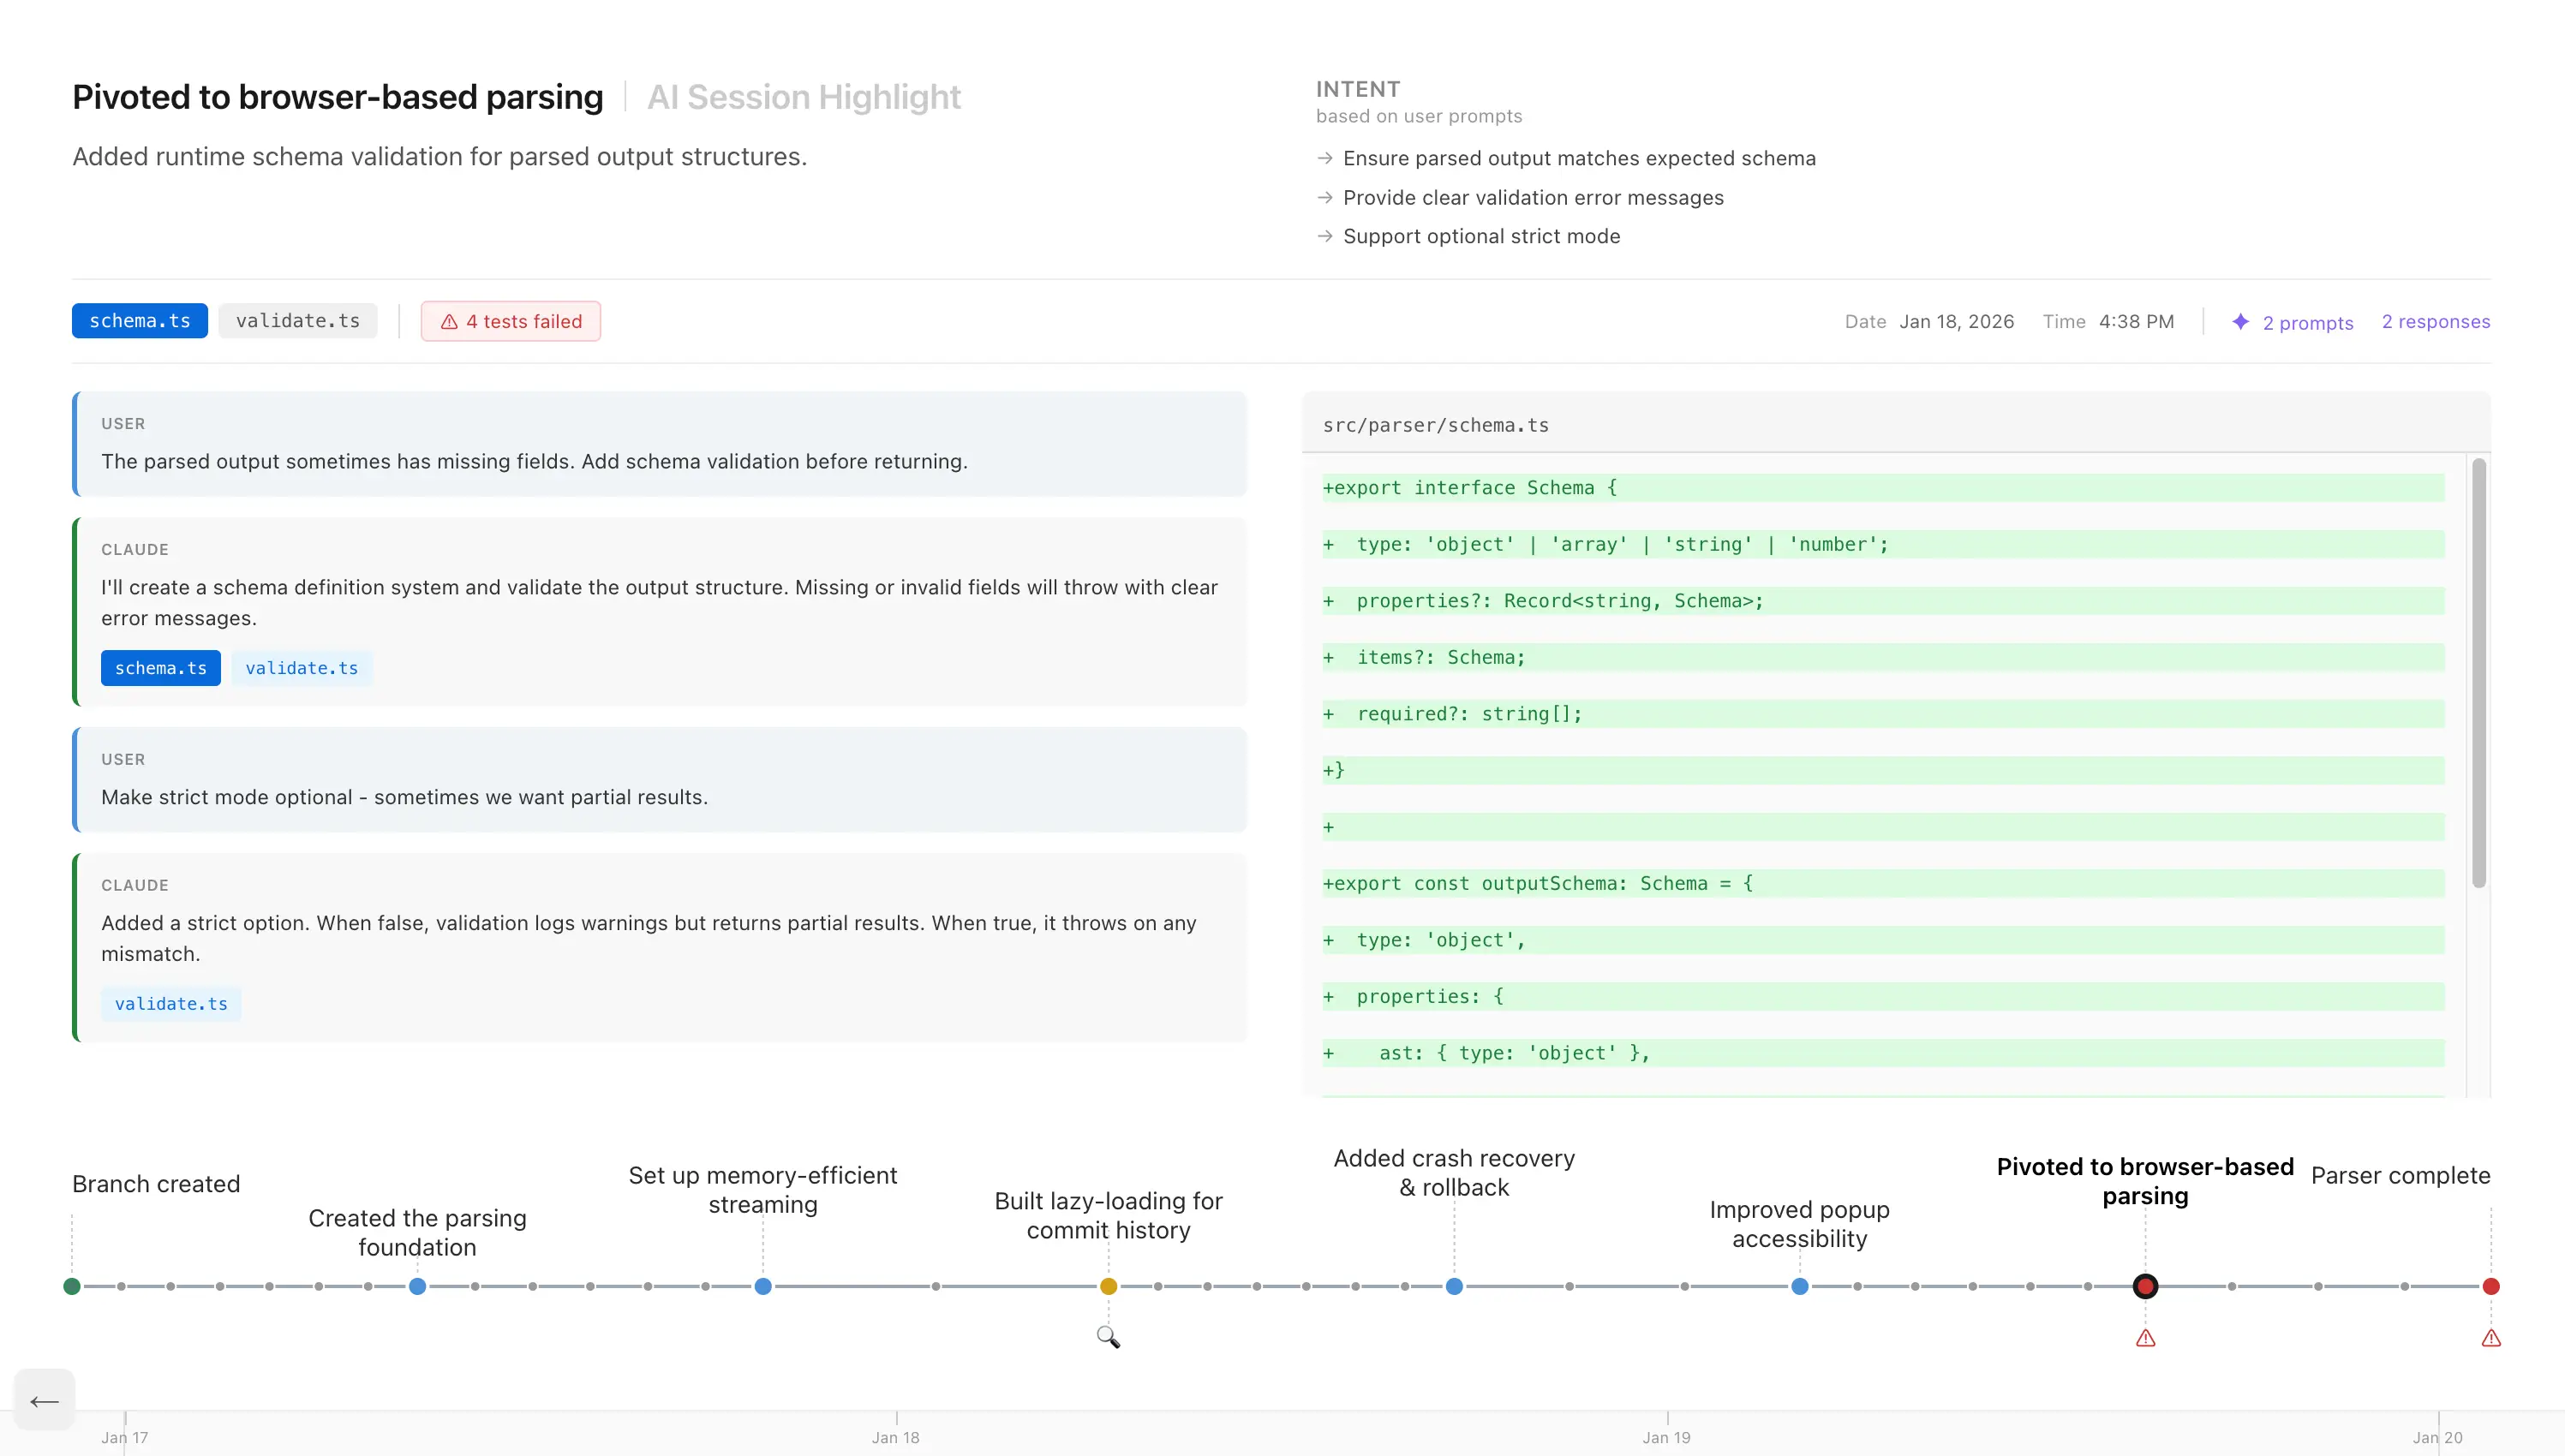
“在这个界面中,我们不仅提供差异比较,还展示了工程师与 LLM 在开发功能时的对话视图。对于每个受影响的文件,我们都包含一个指向该文件差异比较的链接。我们还根据用户提示包含一个意图部分,总结工程师试图完成的目标。这一部分展示了附加的上下文信息:如果测试在会话附近运行是否失败,以及交换的提示和响应的数量。”
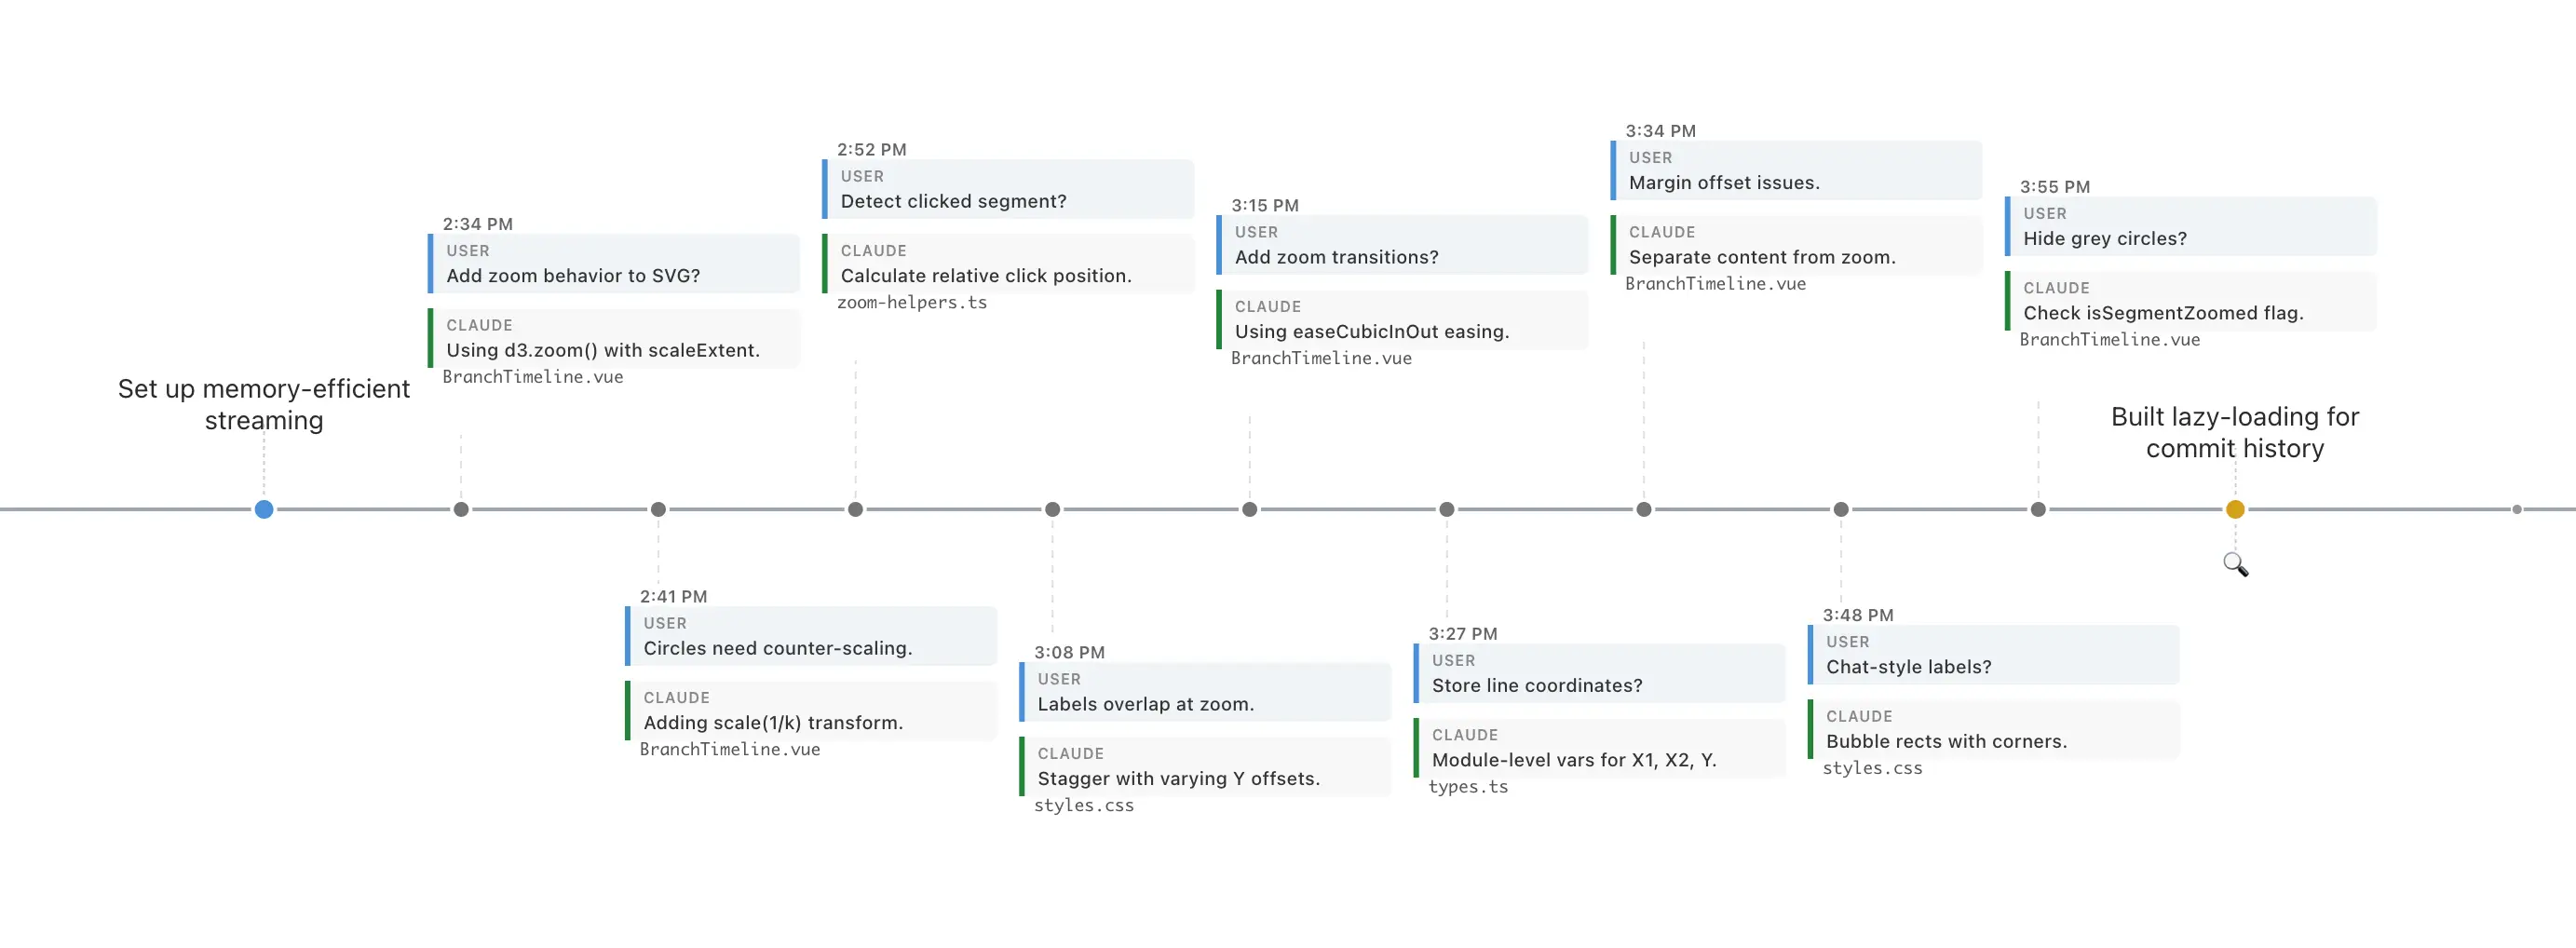
更野心勃勃的一块在于它对“上下文范围”的定义。它不满足于只收集 LLM 对话,它想把代码之外的上下文也挂进来。需求在各种文档里,讨论在 Slack、飞书等 EIM 里,会议上做的决定在纪要里,反馈在 email 中。企业环境里这些东西越来越容易被记录和检索,缺的是把它们和代码改动绑定在一起的界面。它希望版本历史成为组织记忆的索引入口,而不是只记录语法层面的变化。
这篇文章也没有停在想象上,它给了一个可落地的实现路线。工具作为一层覆盖在仓库之上运行,本地模式监听仓库和终端类 LLM 工具的会话日志,发生 commit 时用 hook 捕获日志,做归一化和摘要提取。数据存进一个隐藏目录,既有可检索的索引,也有可共享的元数据。会话和 commit 的关联可以通过 git notes、git trailers 或元数据文件完成,实在不行再用时间戳和文件重叠做匹配。组织级部署再接 GitHub 的 webhooks,同步到共享后端,按角色控制权限,同时也保留隐私与本地模型的选择空间。
它最后把视野放得更远。模型会继续变强,人类不会逐行 review 每个 diff。你会派 agent 去做扫描,去做审计。问题变成另一种问题:人类在哪里做真正的判断。它的答案仍然落在叙事上。你保留了过程,就保留了可讨论的表面。你能看到过去,也能更谨慎地规划未来,甚至在时间线里推演不同路径的后果。软件开发更像写作与修订,版本历史就该像写作史一样可读。
我读完 Narrative Version Control 的最大感受是,它抓住了协作实践必须变化的根因。模型越强,产出越快,协作越需要把“意图”和“证据”从边角料变成主入口。否则你会在 diff 的海里溺水,再强的模型也救不了人类的注意力预算。
现实里不用等一个全新的版本控制工具才开始改变...... 我们可以:
- 要求贡献者或者团队成员给出意图和验证证据,写得短,写得具体。让 reviewer 先判断值不值得深入。
- 把关键对话当作附件证据挂上去,默认只看摘要,需要时再下钻看完整记录。
- 把测试和复现步骤尽量自动化进 CI,把“我测过了”变成可复现的事实。
这三件事的共同点很简单。它们承认了一个已经发生的变化:很多工作发生在对话里,很多风险藏在取舍里,协作必须围绕取舍构建证据链。
这类似于我前面说的那个表单,可以构建这么一个 PR 模板:
- Intent:我要解决什么问题
- Approach:我选的方案与替代方案
- Files:动了哪些关键文件和为什么
- Risk:可能破坏什么
- Proof:我跑了什么,结果是什么
这样我们 review 才会更清楚自己在拒绝什么,或者在接纳什么。我们在拒绝没有证据的负担和接纳一种新的协作单位,不是在拒绝庞大的代码量,也不是在接纳某个新工具。模型把产出推向廉价,人类要把理解与验证变得可承受。版本历史变得能读,让代码库作为一个可以向前阅读和向后阅读的活文档,这只是顺着这个方向自然发生的结果。
Reference
[1] Simon Willison. A new way to extract detailed transcripts from Claude Code. https://simonwillison.net/2025/Dec/25/claude-code-transcripts/
[2] Surya Narreddi. Narrative Version Control. Affiliation: Thoughts and Experiments. https://x.com/i/article/2015514177851330560.


